
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
模型能否像人类一样真正“看见”,并形成持久“记忆”,是过去两年 AI 领域内最受关注的命题之一。
2024 年,正值大语言模型在文本推理上不断突破天花板,而视觉记忆这一被认为更接近人类认知本质的能力,仍是尚未被探索的领地。前 Meta 现实实验室(Reality Labs)研究员沈俊潇(Shawn Shen)与周恩民(Ben Zhou)看到了这一领域的机会,在硅谷创办 Memories.ai。
2025 年 7 月,公司走出隐身模式,发布全球首个大型视觉记忆模型(LVMM),同步完成 800 万美元种子轮融资。DeepTech 曾对话沈俊潇,在当时的他看来,公司的目标是让 AI 拥有“类人视觉记忆”,进而服务于安防、个性化助手、媒体创作等场景。
一年多过去,Memories.ai 的成长节奏明显加快。种子轮追加至 1,600 万美元,与高通、英伟达建立合作;并在 2026 年 1 月消费电子展(CES)上发布 LUCI 开发者硬件平台;一系列围绕视觉记忆与模型自进化的研究成果接连发布,还从 Meta 挖来首席 AI 官。
真正值得记录的不只是这些进展。近日,DeepTech 在硅谷再次与沈俊潇对话,他对公司的组织方式,对视觉记忆和物理 AI 的判断,都进一步收敛至更清晰的维度。
Memories.ai 一直保持着精简的团队规模。创业以来,沈俊潇大部分的时间不是花在管理公司上,而是作为掌舵者把握公司的发展方向,还有最重要的一点,招到对的人。
沈俊潇曾在公司内部做过一个小实验:让 5 个人和 1 个人分别做同一件事,最后发现 1 个人反而更快。因此,他现在招人更看重高能动性,以及与公司愿景对齐(vision aligned)。
他向我们介绍了公司最新的聚焦方向:记忆只是最基础的事,更重要的,是让 AI 通过视觉记忆实现自我进化。
记忆的两种定义
“AI 记忆”这个概念在 2024 到 2025 年间经历了一次快速膨胀。个人化助手需要记住用户偏好,长上下文对话需要跨会话检索,检索增强生成(RAG)被广泛用于知识管理。到 2026 年,开源工具 Mem0 已经把文本记忆做成了标准化组件。
在对话中,沈俊潇把“AI 记忆”一分为二。第一种为个性化服务,让 AI 更懂你;第二种为自我进化服务,让 AI 把活干得更好。他判断,前者的护城河正在快速消失:“随着大模型能力越来越强,这些东西都会被基础模型直接内化。所谓的个性化 AI,实质上只是一批 Markdown 文件加一层智能体的执行框架。”
真正让他觉得值得投入的是第二种。沈俊潇告诉 DeepTech,“我们讲的记忆更多是关于世界的记忆”,目标是让机器人和物理智能系统在部署到新场景时,能够依靠积累的视觉经验自我修正、自我提升,最终达到“物理世界的递归自我进化”(Physical RSI)。
这个判断建立在一个关键的技术前提之上:文字是大模型的原生模态,但视频不是。
大语言模型可以通过写笔记、做摘要、调用检索工具,自主管理文字记忆。但视频太密、太重、太非结构化,还被时间轴锁定。用沈俊潇的话说:“想管理好视觉上下文,需要搭建用于索引视频,生成结构化数据并以特定方式存储的脚手架,这是一套巨大的基础设施工程,很难由大语言模型自主搭建。”
做好视频记忆的脚手架,是 Memories.ai 一系列技术工作的核心。他们在编解码器(codec)层面做压缩编码,自主训练模型,将视频转成向量,把视频转成描述文本。所有经过编码和索引的视频数据,最终都汇入公司自建的视频数据湖。
投资方三星 Next 披露,Memories.ai 在发布 LVMM 时已经索引了超过 100 万小时视频,通过记忆整合把片段压缩为关键视觉特征,同时保留上下文关联,其视频记忆容量是同类方案的 100 倍。
这一策略已经得到了大厂认可。2025 年 11 月,公司与高通建立合作,LVMM 2.0 从 2026 年起在高通处理器上原生运行,将编码、压缩和索引功能下放至设备端,以此降低延迟、节约云端成本、保护隐私。今年 3 月的 GTC 大会上,Memories.ai 的视觉记忆技术被接入英伟达的 Cosmos-Reason 2 和 Metropolis 平台。
“每轮迭代提升 1% 到 2%”
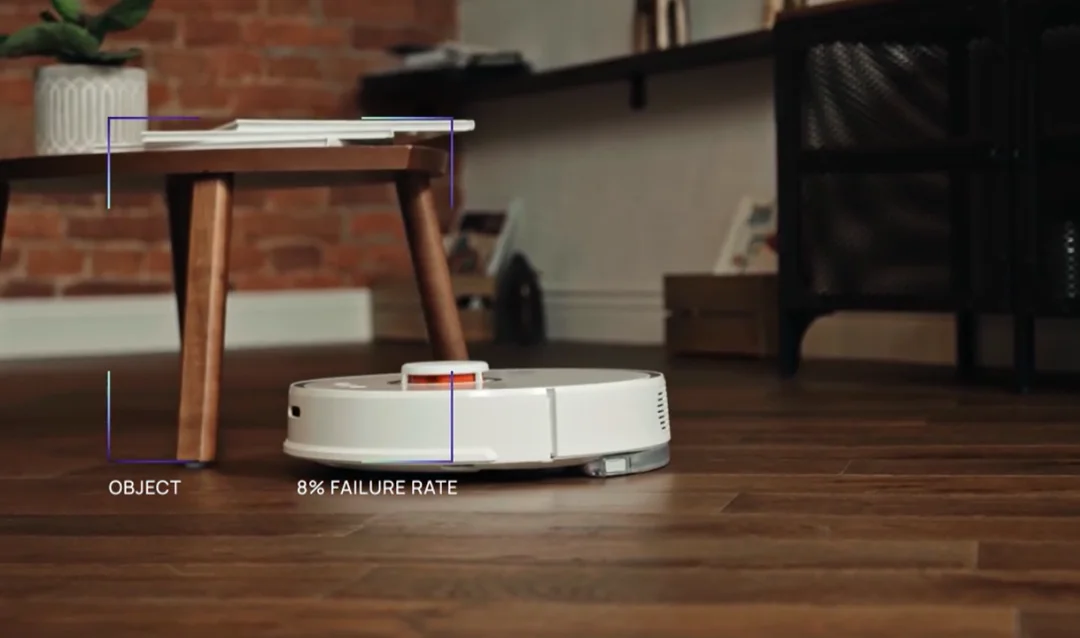
沈俊潇对物理 AI 自进化的预期是,公司为客户部署视觉理解模型时,初始准确率大概在 70%,后续通过模型自我进化,准确率可以升至接近 90%。“每次迭代提升 1%~2% 左右,同时把对人类标注数据的需求量压至最低。”
他进一步解释了具体流程:模型部署到新场景后,Memories.ai 的视频数据湖将持续记录所有原始视觉数据。当模型出现识别错误、决策失误、场景理解偏差等失败模式(failure pattern),系统会自动从视觉记忆中定位相关片段,把失败案例反馈至模型训练环节,进行针对性的后训练。
以具体场景为例,沈俊潇描述了他们希望达到的目标状态:“未来部署一个机器人到新的店,每个店的场景都不一样,边缘情况(edge case)也不一样。客户肯定不希望每次出现边缘情况,都由专人负责对其定义。最好的情况是,所有过程都被记录下来,机器人自己直接从中学习怎样做得更好。”
(来源:Memories.ai)
这一方向和当下物理 AI 的核心痛点相契合。数据平台厂商 Voxel51 2026 年 6 月发布了《2026 视觉与物理 AI 现状报告》,他们发现,78% 的团队正在从视觉与物理 AI 项目中获得实际价值,但几乎所有团队都反映模型表现不达标。模型架构不是主要限制,数据质量、样本覆盖度、标注工作流和类别不平衡才是根本瓶颈。
在沈俊潇看来,加速自我进化的关键并不在算法层面:“算法只能在失败模式中获得加速,但我们想做到的是,出现 100 个失败样本后,能把它全部都用起来,以此进一步提升模型的能力。”
场景明确后,Memories.ai 的商业模式也比刚成立时更清晰了。
沈俊潇把客户明确分成两类。第一类是工厂、连锁快餐店和商超等企业客户。这些场景需要用视觉理解模型做标准作业程序(SOP)检查、库存监控、异常识别等工作。Memories.ai 帮他们做视觉模型的后训练和部署,同时把这些场景里产生的真实视频数据留在自己的数据湖里。
第二类是主攻视觉-语言-动作(VLA)模型或世界模型的前沿机器人实验室。Memories.ai 把从企业场景积累的视频数据分享给这些实验室,帮助他们训练机器人模型,这些机器人未来又可以部署回工厂和商超场景。
从场景数据到前沿实验室,再到反哺机器人运行,一个数据飞轮就此形成,给公司带来了自我造血的能力。
用真实世界和真实需求做生意
所有看重数据的团队难免都会面临一个选择:究竟是用更好的架构以少量数据取胜,还是通过数据规模取胜。对于这个问题,沈俊潇的态度很明确:“我个人更相信规模化(scaling)。大家靠着 scaling 发展到今天,未来依然如此。当然,也不排除未来可能会出现新的技术突破,让 scaling 变得不再必要。”
至于数据来源,沈俊潇告诉 DeepTech,他更偏好真实世界的数据。对比之下,仿真环境虽然可用,但模型最终仍要在真实环境里部署、接受检验;世界模型则更适合作为基础模型,结合机器人数据开展后训练。
这些判断并不意味着 Memories.ai 无视了数据的利用效率。事实上,团队近期发布的多项研究成果都与压缩、内存效率、多模态融合密切相关。MARC 通过强化学习驱动的令牌压缩,把视觉令牌负载降低 95%,同时保留完整帧模型的推理能力;O-MARC 让全模态音视频推理速度提升 34.6%、内存效率提升 34.7%;OmniRetriever 在音频、视频、文本的统一检索空间里,音频检索零样本表现超过谷歌 Gemini;SpatialMem 则通过标准第一人称 RGB 视频构建可查询的 3D 索引。
在物理 AI 领域,Memories.ai 的竞争对手有很多。问及和其他同类型公司最大的差异时,沈俊潇强调了两点关键优势:一方面,他们将视频数据湖与视觉理解模型深度绑定,数据可伴随企业客户的部署天然沉淀,无需从外部采购;另一方面,公司已经找到了合适的生态位,将业务明确限定在“为客户做数据评估和模型后训练”,既不计划亲自下场做机器人,也不会抢 VLA 模型公司、世界模型公司的生意。
访谈接近尾声,沈俊潇再次与 DeepTech 聊起了 AI 记忆的定位转移。在他看来,记忆作为一个独立品类的市场空间已经很有限,“真正把记忆做成一门好生意的公司其实很少”。
个性化记忆是长程任务里的一环,但不应是终极目的:“记忆固然让人变得更独特,例如我知道我昨天、前天都做了什么。但对于模型来说,重要的不是让 AI 懂你,而是看它能不能利用记忆帮你把任务完成得更好,最好是用很少的提示(prompt)完成更长程的任务。”
从更宏观的角度看待未来趋势,沈俊潇把 AI 系统分为“内核”和“外核”:内核指模型能力,外核指个性化、交互体验、言行举止更接近人等体验层的差异。“当内核还在指数级增长的时候,大家会更专注内核,其他事情都显得没那么重要。等内核不增长了,才轮到从外核处寻找差异化。而现状是,内核依然在不断膨胀。”
文章来自于微信公众号 “DeepTech深科技”,作者 “DeepTech深科技”


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
