
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
openJiuwen AgentMemory正式上线了多模态记忆能力OmniMem-Lens:按秒盲切是记忆碎片化的元凶,按真实事件记忆才是正解——召回精度最高提升45.7%,在线问答时延最高降低97%。
在AI智能体(Agent)与多模态模型(VLM)快速演进的今天,我们已经不满足于让Agent处理单一的文本工作了,而是让它干更复杂的活儿。
比如“看完3小时的新品发布会,并找出所有产品亮点”,或者“分析一整天的监控视频,并标记出异常事件”。
然而,现有Agent面对超长视频时,海量信息会瞬间超出其上下文限度,导致处理能力和准确度大大下降。
目前业界的通行做法,是粗暴地把长视频按固定时间窗口(如一分钟)切分成一小段一小段,让智能体分开去记忆。
这种方式如同盲人摸象,给智能体记忆带来了两个致命伤:
① 记忆被切碎——证据碎片化
一段原本连贯的老师讲解,在中间被切断,前半段和后半段被智能体分开处理、分开存储。当用户提问时,智能体只能拿到半个“断章取义”的证据,于是胡编乱造、幻觉频出。
② 记忆被稀释——证据淹没
一个几秒钟的关键动作,与前后几分钟无关的背景画面强行打包。智能体检索细节时,关键信息被大量噪音淹没,召回精度断崖式下跌。
问题的根源是,Agent是“按秒”在记视频,而人是“按事件”在理解视频。
打个比方,你回忆昨天看过的电影,会按“主角相遇→误会→和解”这样的情节去记,而不是拿秒表每60秒存一段。可现在的Agent,恰恰是拿秒表在记电影。
更棘手的是,市面上大多数视频事件分割方案只依赖单一模态,只看画面,或只听语音。可这两条路都会失灵:画面长时间不动时,它看不见内容其实换了议题;没有台词时,它听不到任何线索。
这不是算力不足,而是记忆在切分源头就失去了“焦点”。
为了让智能体像人类大脑一样真正处理长视频,团队在openJiuwen AgentMemory 0.2.0版本中正式上线了OmniMem-Lens(多模态记忆透镜)能力。
作为AgentMemory针对视频多模态记忆处理的核心技术,OmniMem-Lens开创性地通过视觉和听觉两条轨迹来理解视频中的事件,并以此完成记忆内容的组织,让Agent的视频记忆第一次真正做到——按事件存,按事件取。
团队对它的定位是:给智能体装上一个懂得“自动定焦”和“分层整理”的超级海马体。
它做对了三件事:按真实事件切、分层存记忆、离线建好在线查。
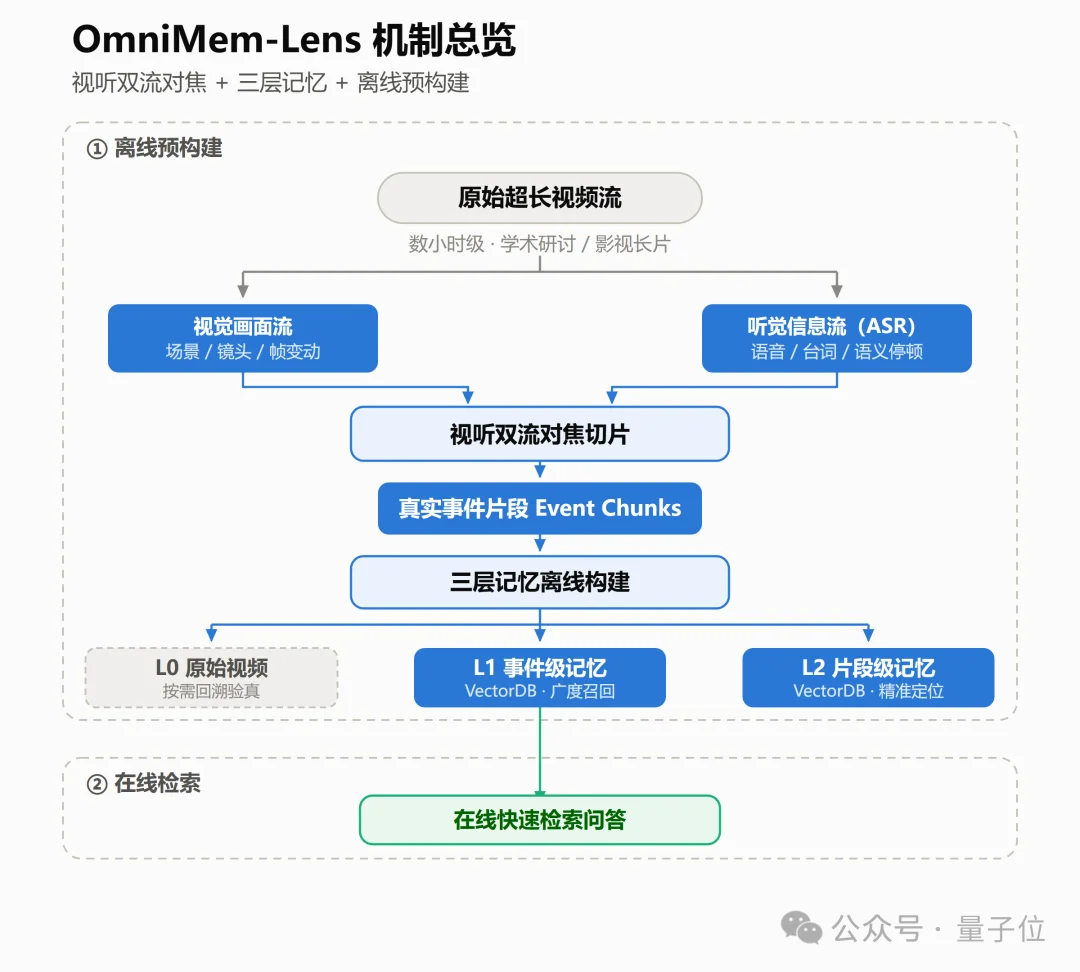
OmniMem-Lens给智能体同时装上了“眼睛”和“耳朵”:眼睛看画面,画面切换时判断出变化并标记;耳朵听语音,画面没动但说话人换了话题时,通过ASR语音转录分辨出来。
双证据交叉对焦,长视频被切分在真实事件边界上,智能体对视频的理解从此不再“断章取义”。
用户的每次提问,需要的证据颗粒度可能都不一样。OmniMem-Lens在后台建立了一个三层记忆单元:
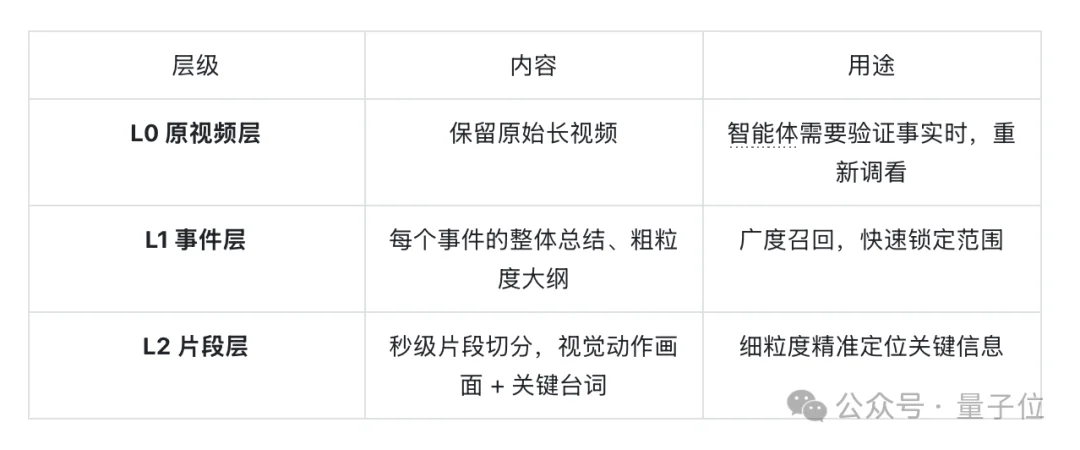
要大纲有大纲,要细节有细节,检索时按需取用,互不干扰。
就像一本带目录和索引的书:目录(L1)帮你翻到大致章节,索引(L2)帮你定位到具体某一句话,原文(L0)随时可以翻回去核对。
同时,L1与L2记忆单元完全文本化与向量化,可以无缝接入主流向量数据库——对已有RAG/Agent技术栈的开发者来说,几乎零改造即可用上。
如果每次不同角度的提问,都需要智能体把几个小时的视频重新看一遍,不仅反应极慢,还会消耗巨大算力。
OmniMem-Lens把繁重的记忆整理工作提前在离线做完;智能体面对提问时直接查记忆,做到秒级响应,问什么答什么。
在线检索的链路并不复杂:用户Query先与L1/L2的记忆单元做语义匹配,快速定位到精炼的多模态记忆;只有当明确需要视觉细节验证时,系统才按需调取L0层的精确视频帧。这种“轻量级文本索引+延迟调取原始视频”的架构,大幅提升了视频记忆检索的效率。
OmniMem-Lens的设计哲学在于:像专业摄像机一样双焦定格事件边界,像三棱镜一样分层折射记忆结构,从而让智能体对长视频的理解,从盲目切割,走向精准透视。
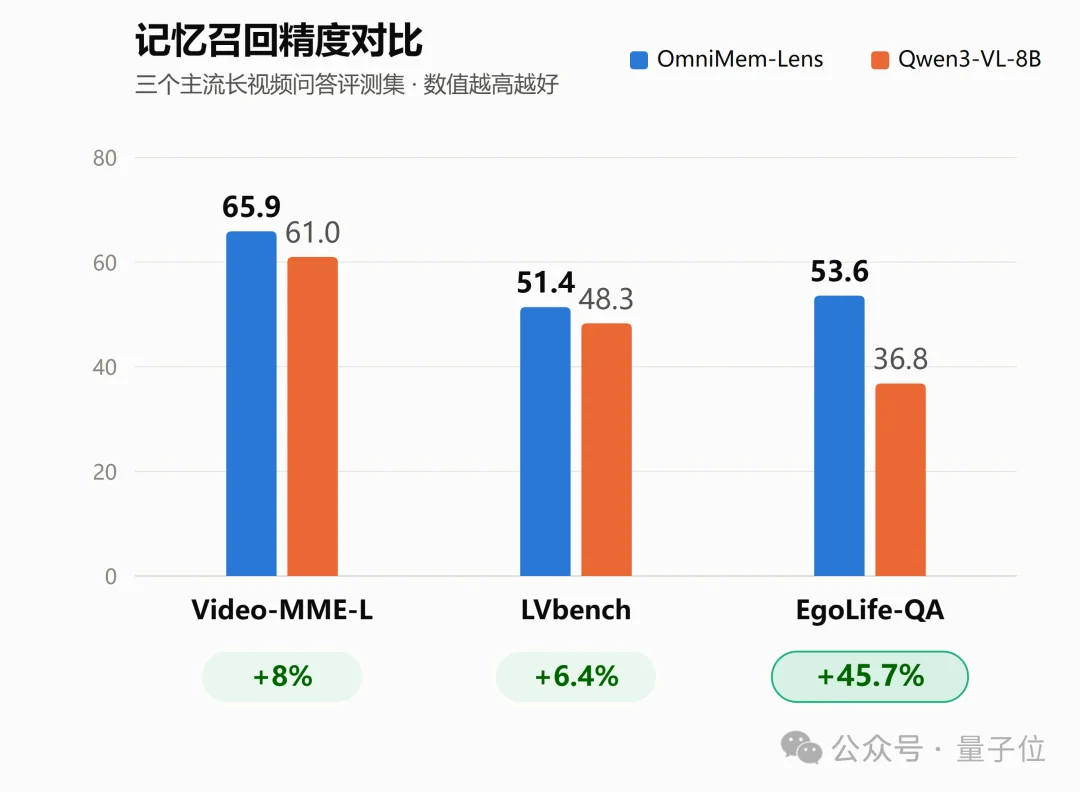
说得再好,不如跑一遍数据。团队选取了三个主流长视频问答评测集,将应用了OmniMem-Lens能力配合Qwen3-VL-8B模型处理视频记忆问答,与直接使用VLM模型Qwen3-VL-8B处理视频内容问答进行对比。
💡 一句话看懂下面的表:
“召回精度”越高=找到的证据越准;
“在线时延”越低=等答案的时间越短。
① 记忆召回精度:三个评测集全面领先
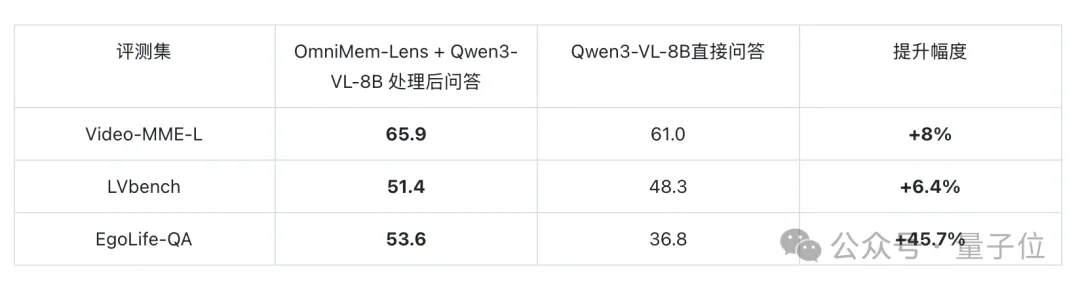
在通用长视频基准Video-MME-L上提升8%,长视频理解基准LVbench上提升6.4%。
最亮眼的是EgoLife-QA上的+45.7%——这个评测集以第一人称视角记录一整天的日常生活,事件密集、细节琐碎,恰恰是固定切分最容易失效的场景,也最能体现“按真实事件组织记忆”的价值。
② 在线问答时延:从“重新看一遍视频”到“直接查记忆”
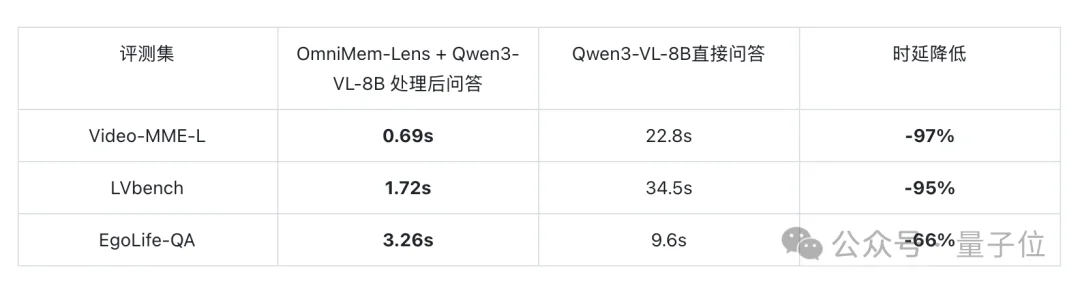
视频越长,VLM直答需要“啃”的画面就越多,时延也就越长——LVbench上Qwen3-VL-8B要等34.5秒,OmniMem-Lens只需1.72秒,快了整整20倍。
换成生活场景:VLM直答像每次都把3小时的电影从头到尾重看一遍再回答你;OmniMem-Lens像一位看电影时就已经做好笔记的影评人,你问哪段,他翻笔记直接答。
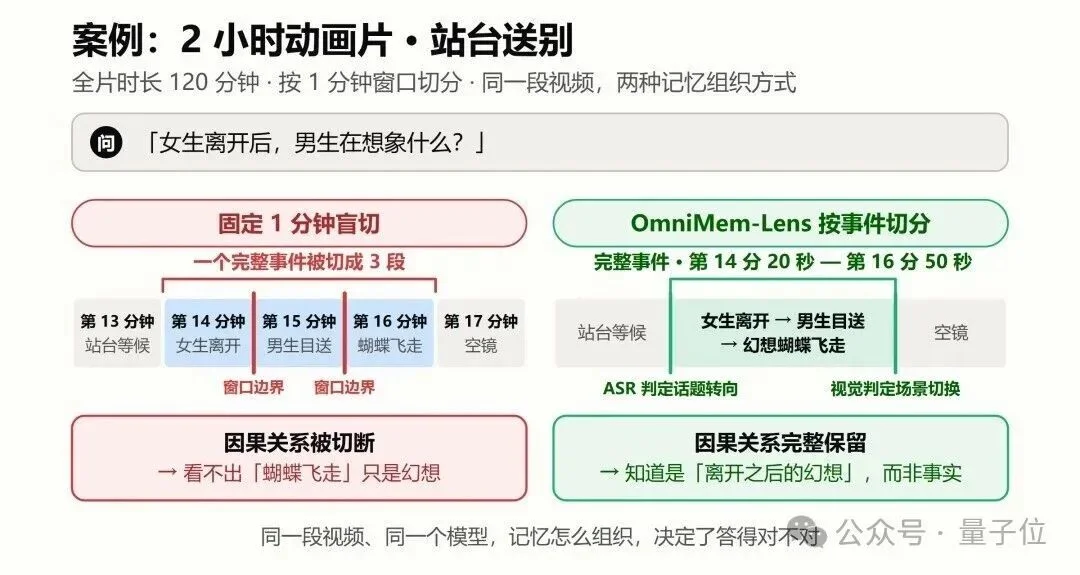
以一段2小时的动画片为例:站台上,女生离开、男生目送,女生离开后,男生幻想她变成蝴蝶飞走。
固定1分钟盲切把这段120分钟的视频切成120个片段。而“女生离开→男生目送→幻想蝴蝶”这个完整事件,从第14分20秒持续到第16分50秒,恰好横跨第14、15、16三个窗口,被窗口边界连切两刀。
于是碎片变成了三段互不相干的记录:第14分钟「女生离开」、第15分钟「男生目送」、第16分钟「蝴蝶飞走」。
当用户查询“在女生离开后,男生在想象什么?”时,检索到的片段里只有“男生目送”和“蝴蝶飞走”,却没有任何线索说明这蝴蝶只是幻想——智能体把它当成了真实发生的事,答非所问。
OmniMem-Lens则把这个事件作为完整的一段(第14分20秒—第16分50秒)存进记忆:ASR流听出话题转向,视觉流捕捉到场景切换,双流对焦在真实边界落刀。“女生离开后再幻想”的因果关系被完整保留,事实与幻想分得清清楚楚,准确回答。
同一段视频,不同的记忆组织方式,就是“答不出”和“答得准”之间的差距。
上面这个例子靠视觉线索就能解决。而下面这个场景,光有眼睛是不够的。
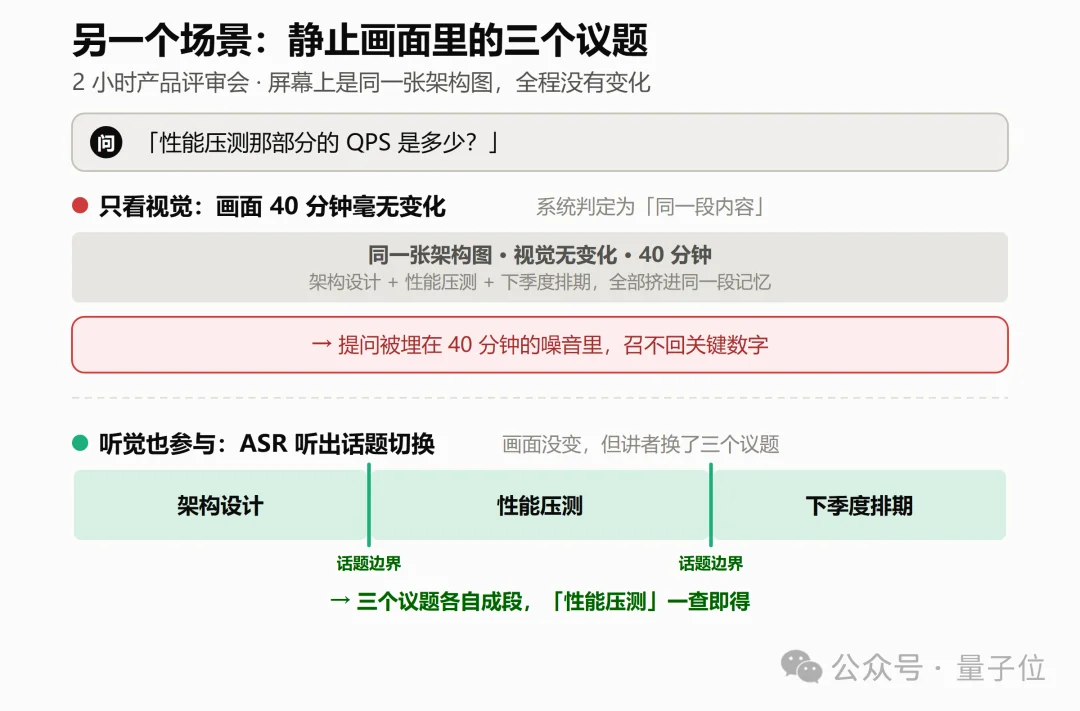
一场2小时的产品评审会,屏幕上始终是同一张架构图,40分钟没有任何变化。但这40分钟里,讲者先后讲了三个独立议题:架构设计、性能压测、下季度排期。
只看视觉的方案(以及固定窗口盲切)看到的是“一段静止画面持续40分钟”,于是判定为同一段内容,把三个议题打包进同一条记忆。当用户问“性能压测那部分的QPS是多少”时,关键数字被埋在40分钟的噪音里,召不回来。
OmniMem-Lens的ASR语音流听得出来:画面没变,但讲者在换话题。语音一旦转向,系统立即落刀——三个议题各自成段,提问时一击即中。
这正是视听双流的价值所在:视觉失灵时,听觉顶上;听觉失灵时(比如无台词的镜头切换),视觉顶上。任何单独一路都可能漏判,两路交叉才靠得住。
WorkSwarm即将支持对接使用openJiuwen AgentMemory,将日常对话中的视频内容帮你记住,讨论时帮助你快速回忆。
智能体要想真正替人类干复杂的工作,就不能只有“执行力”,更要有“好记性”。
OmniMem-Lens通过让智能体“按真实事件记”与“分层高效查”,解决了长视频场景下智能体记忆碎片化、找不准、反应慢的问题,为多模态智能体打造了一套高精度、极速响应的记忆底座,让智能体在面对长视频时,真正做到“过目不忘、对答如流”。
OmniMem-Lens已在openJiuwen AgentMemory 0.2.0版本正式上线,欢迎体验、共建。
如果这篇文章对你有帮助,欢迎点赞、在看、转发三连,也欢迎在评论区聊聊:你的Agent是怎么处理长视频记忆的?
项目地址:https://gitcode.com/openJiuwen/agent-memory/
文章来自于"量子位",作者 "允中"。

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】Whisper是由openai出品的语音转录大模型,它可以应用在会议记录,视频字幕生成,采访内容整理,语音笔记转文字等各种需要将声音转出文字等场景中。
项目地址:https://github.com/openai/whisper
在线使用:https://huggingface.co/spaces/sanchit-gandhi/whisper-jax
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales
