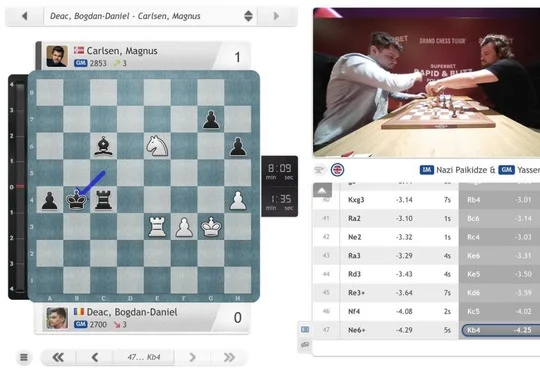
4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?
4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
来自主题: AI技术研报
9737 点击 2026-10-07 15:18

 搜索
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
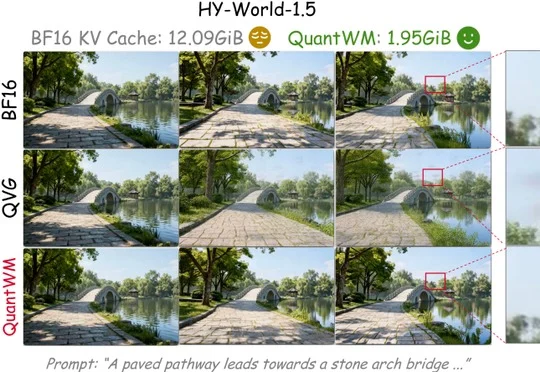
哈尔滨工业大学(深圳)iLearn-Lab与新加坡国立大学LV-Lab提出免训练2-bit KV Cache量化框架QuantWM,改善视频世界模型量化后的时序闪烁与画质,并实现最高6.20倍缓存压缩。
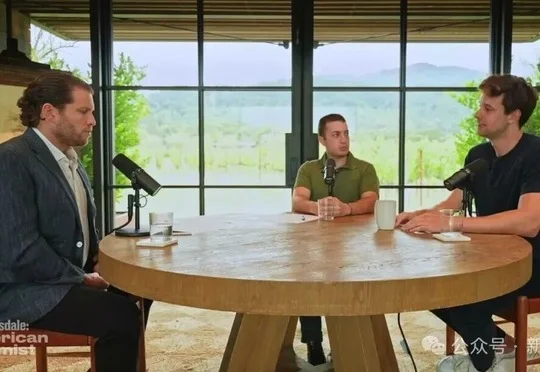
Anthropic强化学习技术负责人Sholto Douglas预测,能力等于甚至超过所有人类的AGI可能在未来几年内出现,2028年AI年度资本开支或达4万亿美元,而研究员Nick Marwell对AI无需人类搭档后的后果表示紧张。
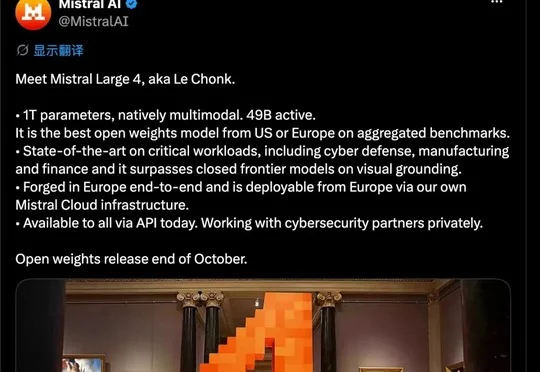
Mistral 发布 Mistral Large 4,采用细粒度混合专家结构,总参数1.05T、每次激活49B,支持图文输入和100万上下文,API现已开放,权重计划于10月27日发布。
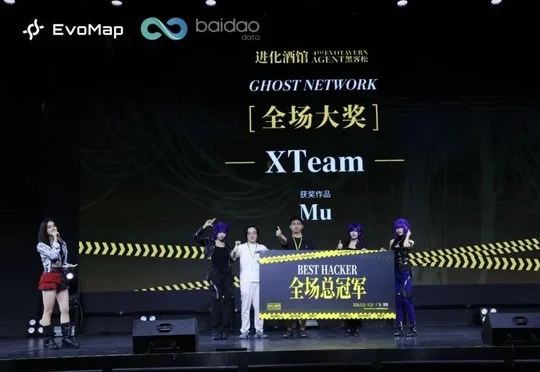
开源项目mu(μ)在进化酒馆黑客松深圳收官战中夺冠,其将Jev深度融合进Harness,通过35个判定点优化上下文管理与多Agent通信。
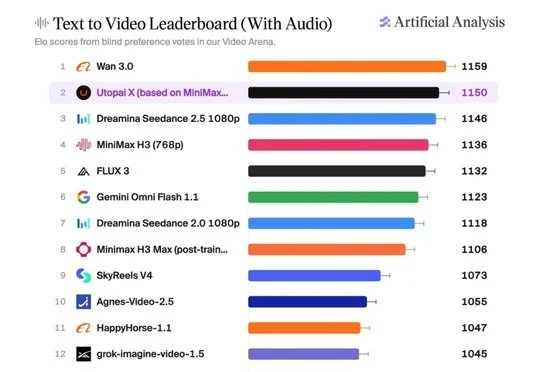
Utopai Studios打造的Utopai X在Artificial Analysis Video Arena盲评中以1150 Elo位列全球第二,其核心竞争力是将模型深度集成PAI制作系统,并通过真实影视项目、专家反馈与系统迭代形成持续进化的数据飞轮。
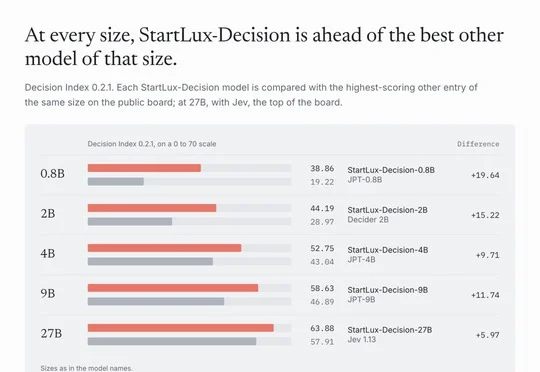
StartLux发布完全开源的StartLux-Decision,其27B版本在Decision Index 0.2.1的38项基准中有31项超过Jev 1.13,并以63.88分升至公开榜首。
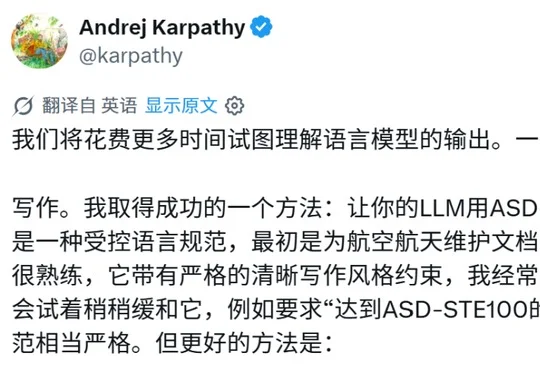
Karpathy建议让LLM采用约80%的ASD-STE100规范,并生成图示、HTML交互页面或定制讲解视频,将输出转化为更清晰易懂的软件产物。
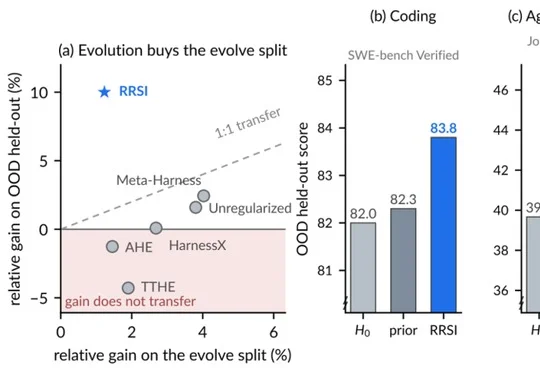
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。