豆包、WorkBuddy、QoderWork怎么选?我用8个真实办公任务把三家桌面Agent测明白了
豆包、WorkBuddy、QoderWork怎么选?我用8个真实办公任务把三家桌面Agent测明白了过去半年,国产大厂扎堆发布一种新东西:桌面Agent。如果你最近在刷相关讨论,会发现 WorkBuddy、豆包专业版、QoderWork 这三个名字出现得特别频繁。如果一个普通办公用户今天就想选一款桌面 Agent,到底该先试谁?
搜索
过去半年,国产大厂扎堆发布一种新东西:桌面Agent。如果你最近在刷相关讨论,会发现 WorkBuddy、豆包专业版、QoderWork 这三个名字出现得特别频繁。如果一个普通办公用户今天就想选一款桌面 Agent,到底该先试谁?
这事听着像钓鱼帖,但偏偏是真的。
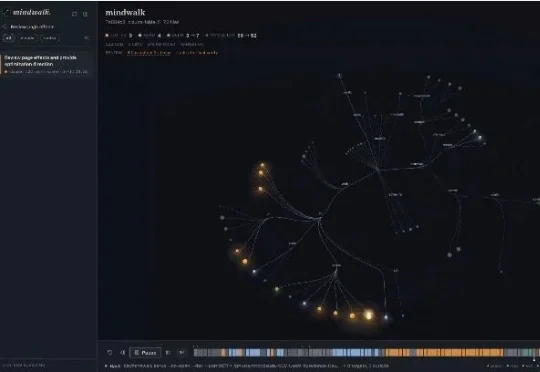
把一个Bug交给Claude Code或Codex,十几分钟后它回了一句“Done”和一大片Diff。过程中它读错了什么、为什么反复改同一个文件、最后有没有重新跑测试......开发者想知道就只能去几百行日志里碰运气。7月11日,一个名叫Mindwalk的开源项目发布了v0.1.0。
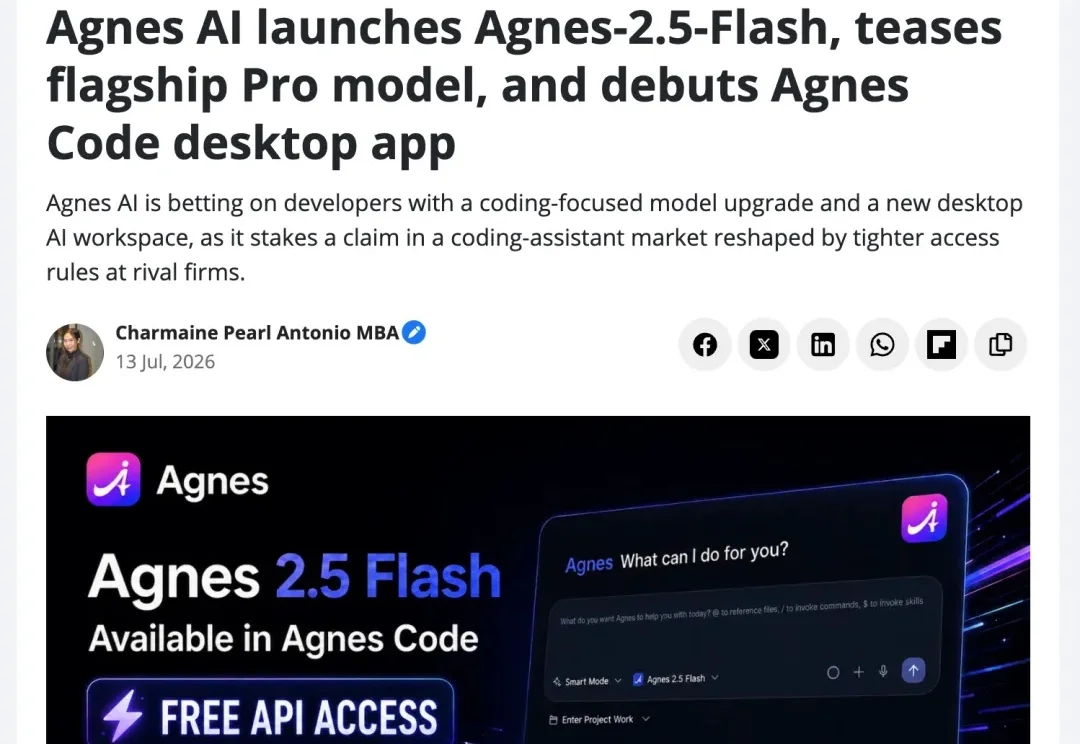
刚刚,Agnes 升级了!
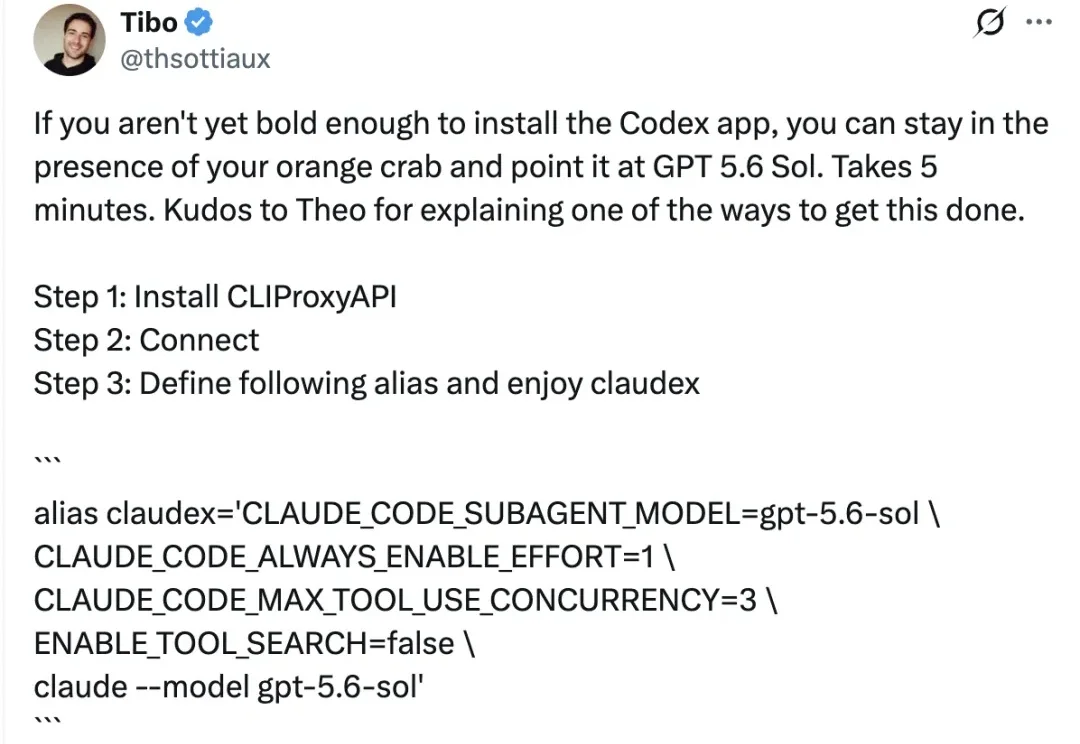
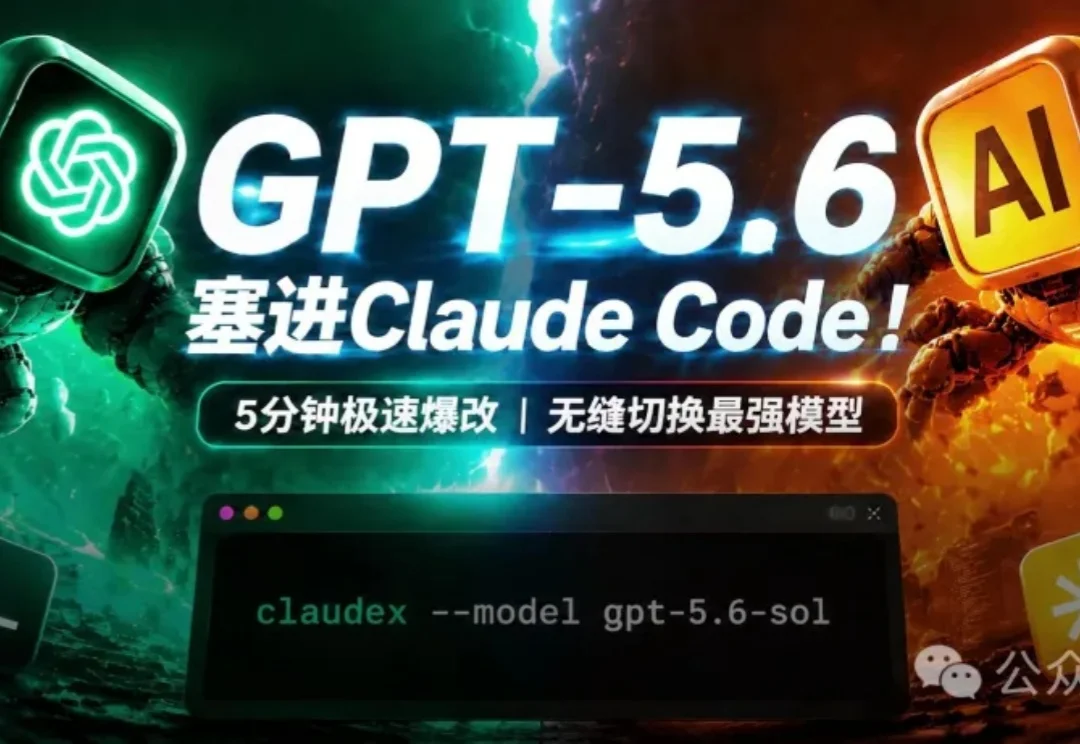
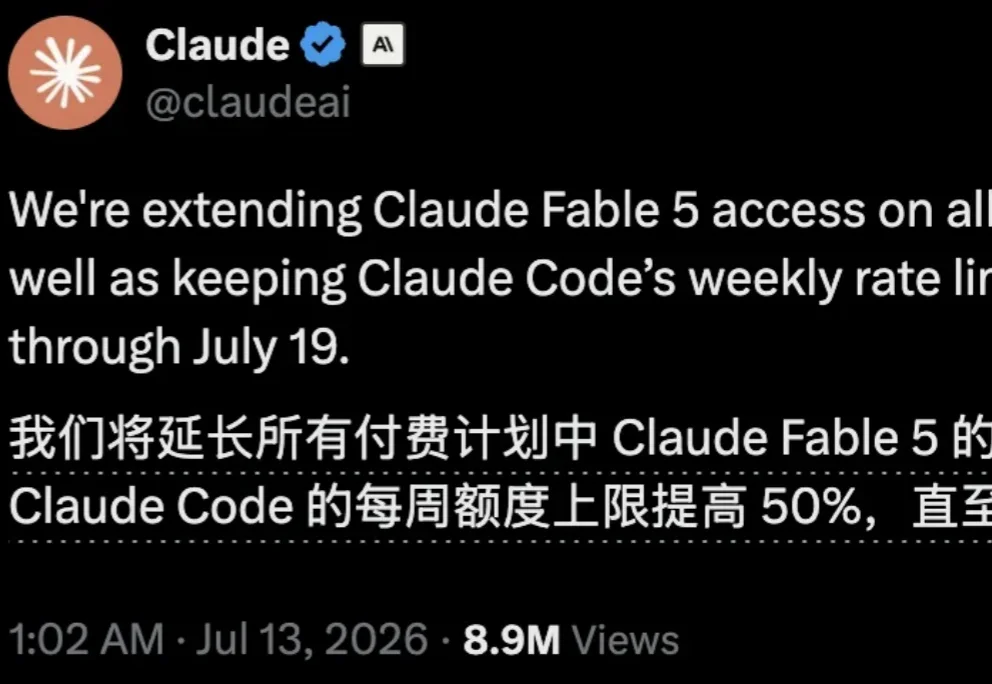
OpenAI高管亲自下场,教开发者5分钟极速「策反」Claude Code,这波贴脸开大太狠了。
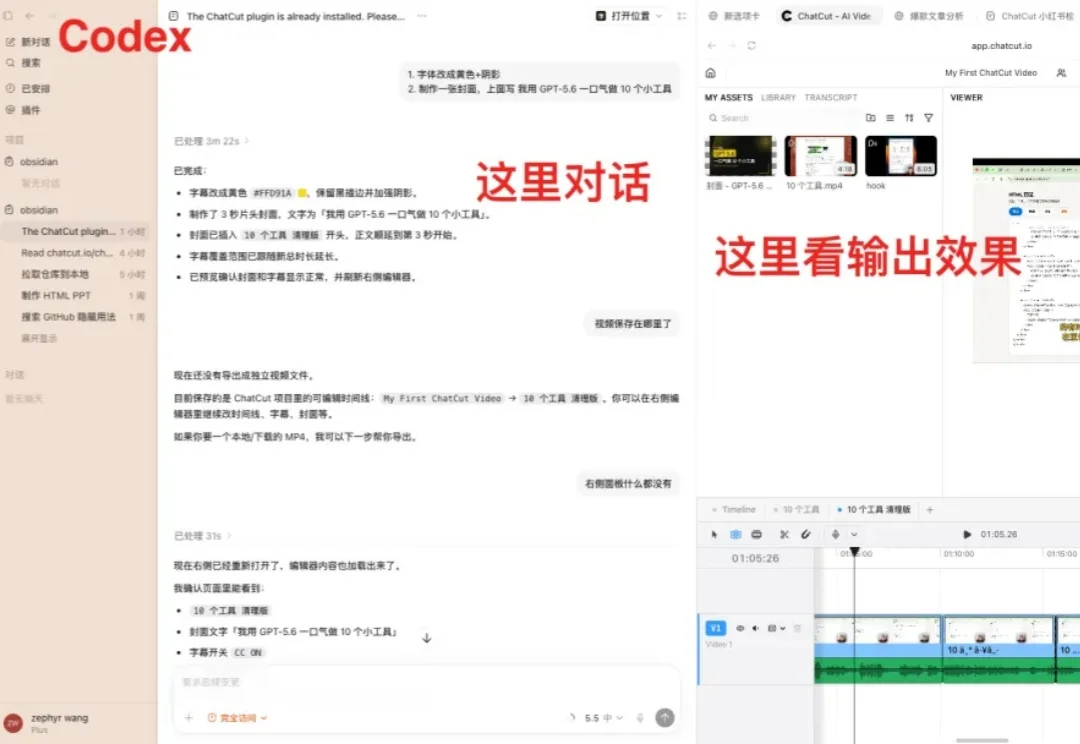
最近刷小红书,总能刷到 ChatCut。
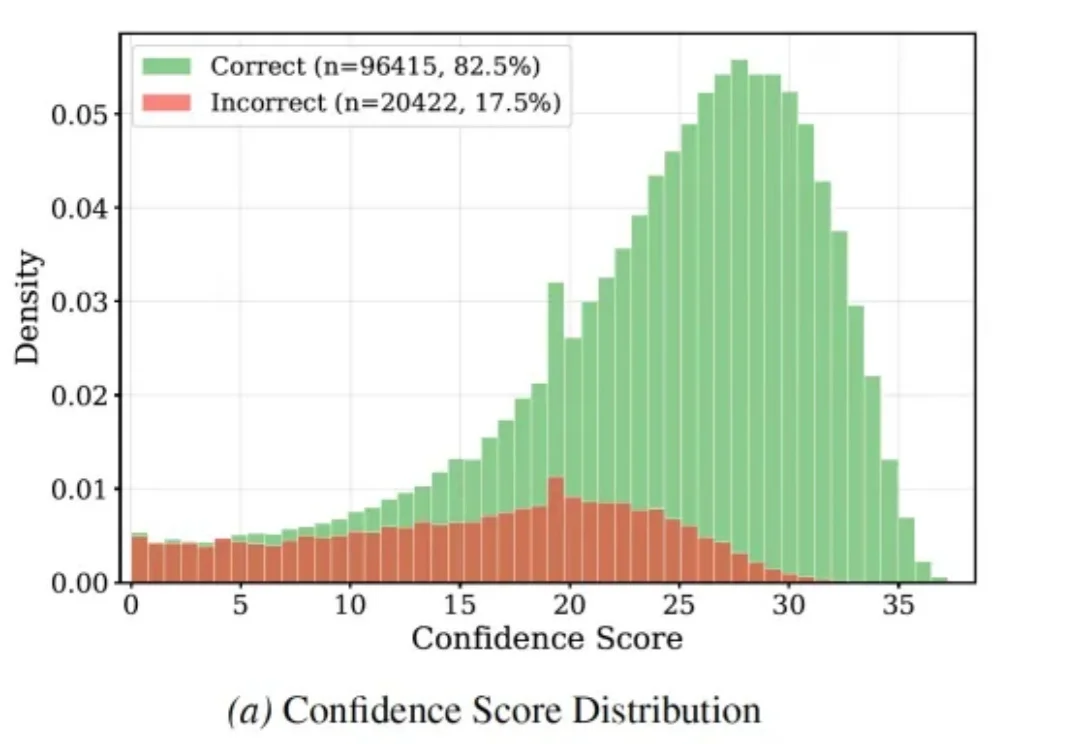
奖励模型(Reward Model, RM)是大语言模型对齐的核心组件,负责为模型输出提供符合人类偏好的评价信号。现有方法各有短板:标量判别式 RM 高效稳定但可解释性有限;生成式 judge 能给出判断理由,却需为每个样本生成长 reasoning,token 与延迟开销显著。
卷起来了!
2026年,AI安全终于被推到了台前。
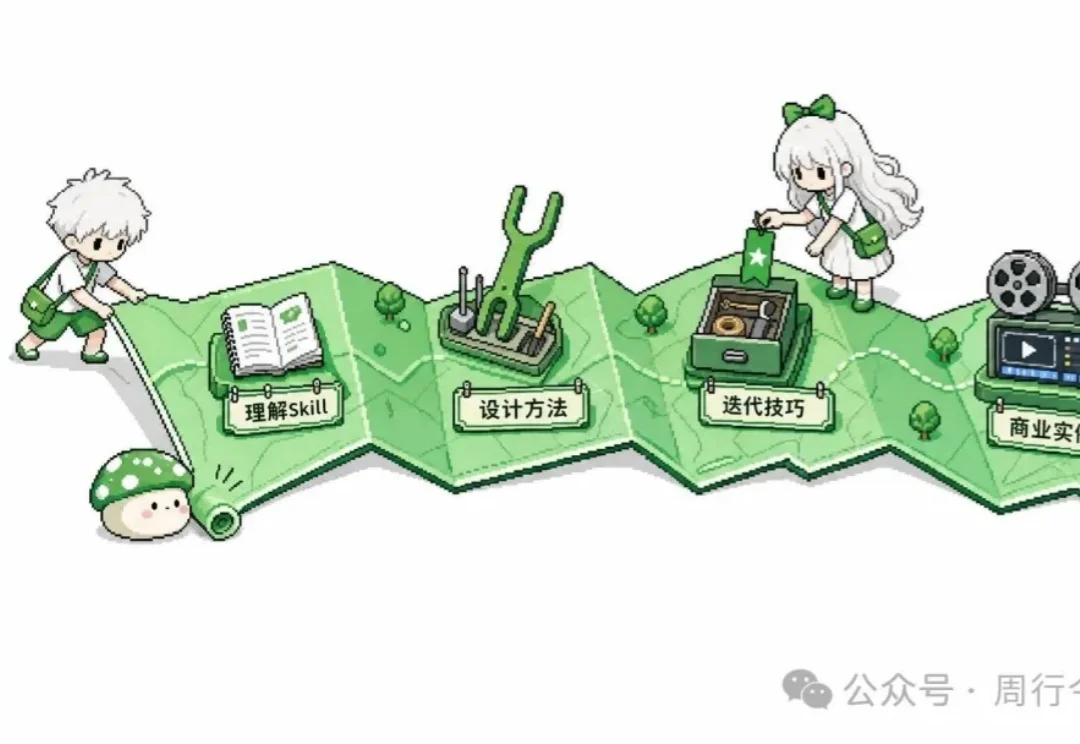
这篇文章,我会从我对Skill的理解、设计Skill的方法、怎么升级和迭代Skill这些维度展开。并且会结合之前的Codex自动化剪辑工作流,尽可能用简单和直白的语言,把Skill讲清楚,确保朋友们看完就能用得上。