担心蒸馏问题,Meta限用Claude Code、Codex
担心蒸馏问题,Meta限用Claude Code、Codex据外媒 The Information 报道:Meta 正在限制员工在 AI 模型构建中使用 Claude Code 和 Codex,原因是担心涉及模型蒸馏。 Meta 担心这些外部模型生成的内容,可能进入自家的训练数据或评测体系,从而引发所谓的模型蒸馏争议。
来自主题: AI资讯
10581 点击 2026-06-30 12:15

 搜索
据外媒 The Information 报道:Meta 正在限制员工在 AI 模型构建中使用 Claude Code 和 Codex,原因是担心涉及模型蒸馏。 Meta 担心这些外部模型生成的内容,可能进入自家的训练数据或评测体系,从而引发所谓的模型蒸馏争议。
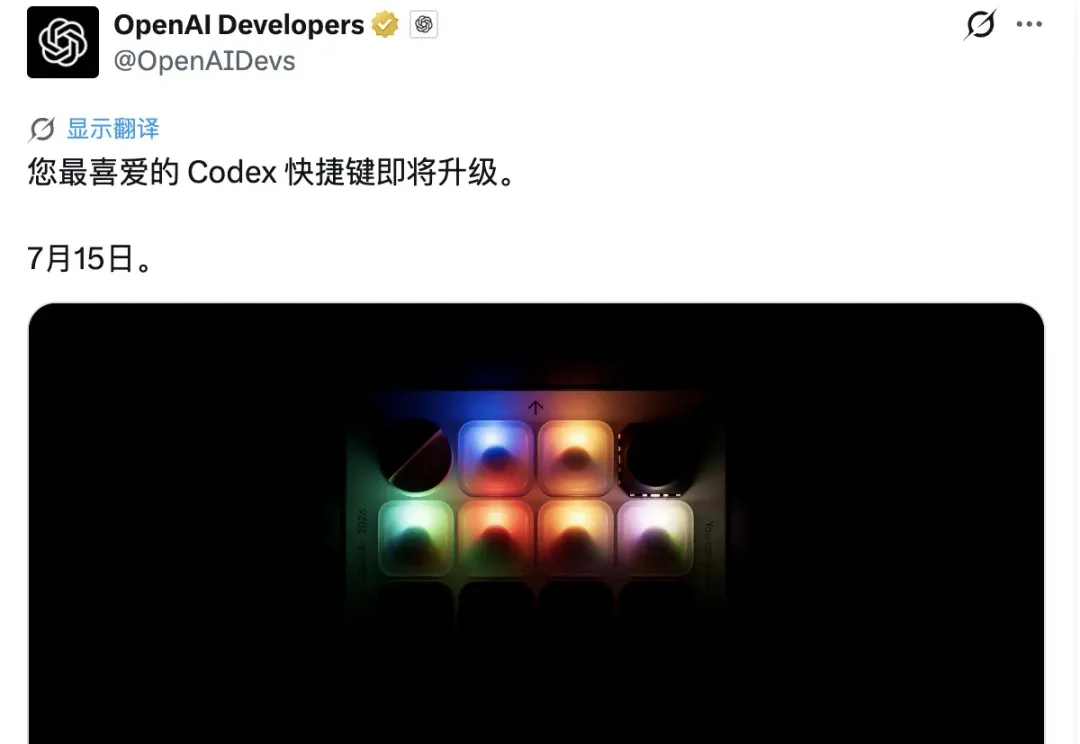
当整个 AI 圈都在翘首以盼 Sam Altman 和前苹果首席设计官 Jony Ive 能联手掏出一部 AI 时代的 iPhone 时,OpenAI 今天却猝不及防地公布了一个键盘。
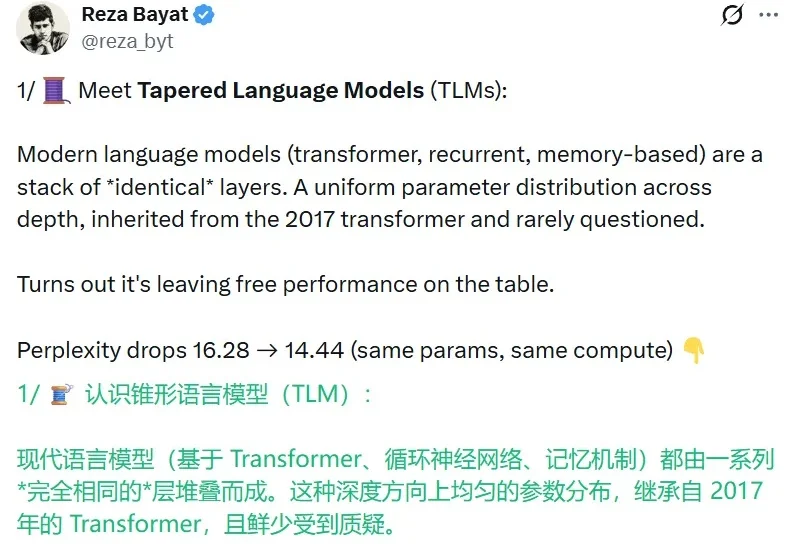
2026 年 6 月,大模型行业正在经历一场前所未有的「开源海啸」:英伟达放出了 550B 参数的混合架构模型,谷歌送出多模态的 Gemma 新版本,智谱用最宽松的协议全量开源了自家旗舰模型。
这两年总有人来问我同一个问题。
你以为自己在用GPT-5.5,但OpenAI可能已经在后台,悄悄把你的底层模型换成了更先进的GPT-5.6 Sol。
最近另一个叫「马尾辫」的项目在 GitHub 上开始被疯狂下载,直接拿下了 GitHub 热门榜单连续三周的周榜第一。这个项目的介绍图也特别有意思,在项目描述里写着,你一定认识他,长长的马尾辫,椭圆形眼镜,在公司待的时间比版本控制系统的历史还长。你给他看五十行代码;他看了看,什么也没说,然后只用一行替换掉。
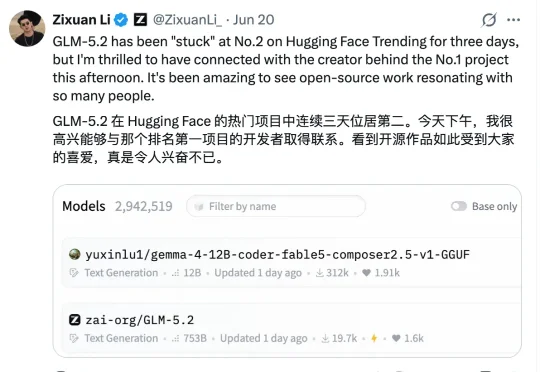
一位个人开发者,竟然在一众大厂中,杀进了抱抱脸Models Trending榜的前排?!突然出现了一个个人账号:yuxinlu1。再一看下载量——最新数据已高达20.7万和53.6万。好家伙,这是什么神仙模型来了?
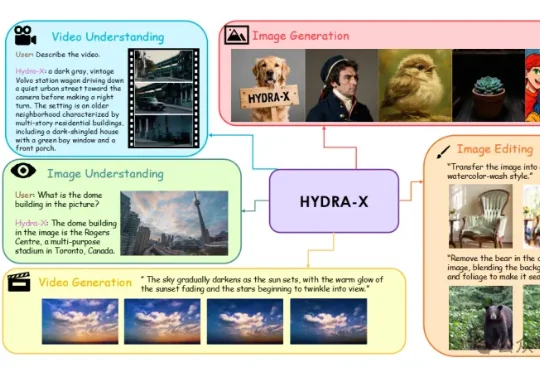
南大王利民团队&腾讯混元的HYDRA系列(HYDRA,HYDRA-X)工作挑战了这个惯例,用一个基于ViT的统一视觉Tokenizer,帮助原生多模态模型更好地“看懂”和“创作”。训练一个基于ViT的Unified Tokenizer,使其同时具有理解和生成的能力,进而同时作为理解和生成的Autoencoder,来支持原生多模态模型(Unified Multimodal Models)的训练。
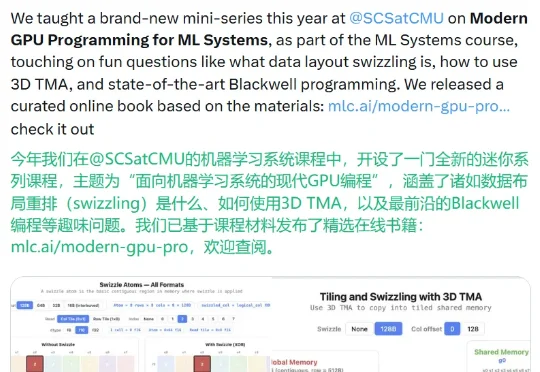
前些天,CMU 助理教授、TVM/XGBoost/MLC-LLM 的创造者陈天奇发布了一本免费在线书籍《Modern GPU Programming For MLSys(面向机器学习系统的现代 GPU 编程)》。
有网友发梗图表示震惊,怎么会有用户一天能运行 Agent 71 个小时。也就是说,在 OpenAI 内部,工作场景里的 AI 使用,几乎已经切到了 Codex 上。Codex 这份报告将衡量 AI 应用深度的指标,定位在我们交出去的任务有多重、agent 替人类跑了多久、用户是不是在同时盯着好几条工作线。