独家|陈天桥布局端到端Deep Research生态赛道,MiroMind发布全栈开源深度研究项目ODR
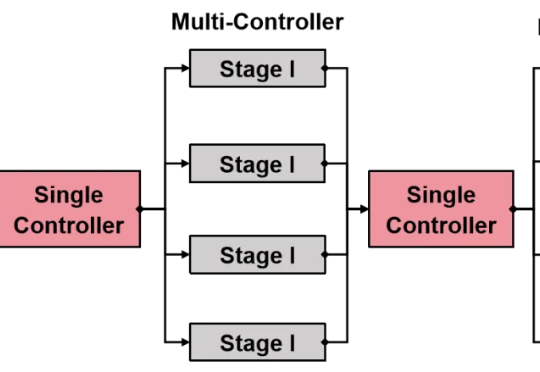
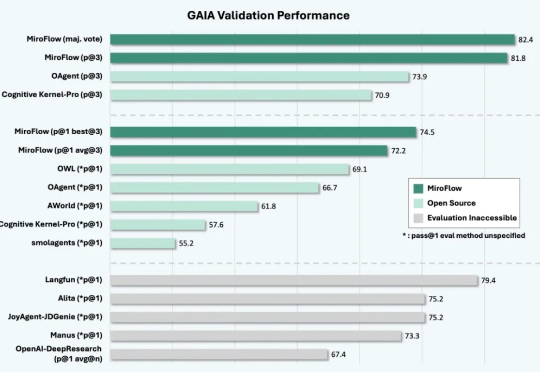
独家|陈天桥布局端到端Deep Research生态赛道,MiroMind发布全栈开源深度研究项目ODR全栈开源生态系统:涵盖Agent框架(MiroFlow)、模型(MiroThinker)、数据(MiroVerse)和训练基础设施(MiroTrain / MiroRL)的全栈开源方案,所有组件和流程均开放共享,便于学习、复用与二次开发。
搜索
全栈开源生态系统:涵盖Agent框架(MiroFlow)、模型(MiroThinker)、数据(MiroVerse)和训练基础设施(MiroTrain / MiroRL)的全栈开源方案,所有组件和流程均开放共享,便于学习、复用与二次开发。
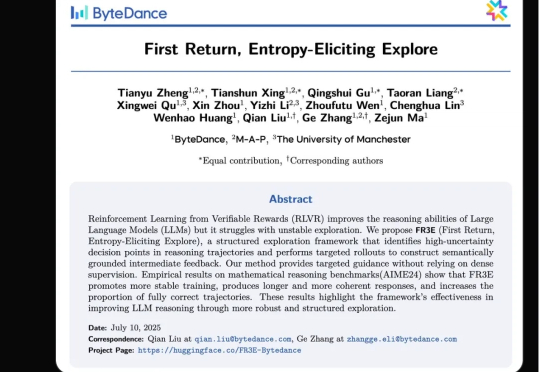
强化学习(RL)范式虽然显著提升了大语言模型(LLM)在复杂任务中的表现,但其在实际应用中仍面临传统RL框架下固有的探索难题。
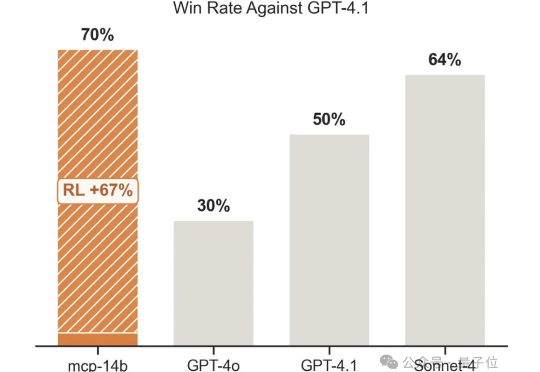
强化学习+任意一张牌,往往就是王炸。专注于LLM+RL的科技公司OpenPipe提出全新开源强化学习框架——MCP·RL。
OpenAI前研究员、Meta「AI梦之队员」毕书超在哥大指出:AGI就在眼前,突破需高质数据、好奇驱动探索与高效算法;Scaling Law依旧有效,规模决定智能,终身学习才是重点。
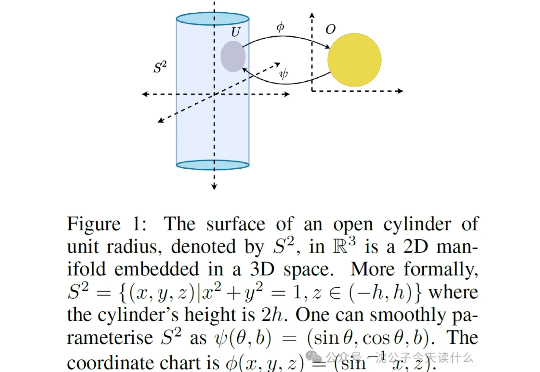
一句话概括,原来强化学习的“捷径”是天生的,智能体能去的地方(流形)被动作维度(低维流形)限制得死死的,根本没机会去那些没用的高维空间瞎逛。
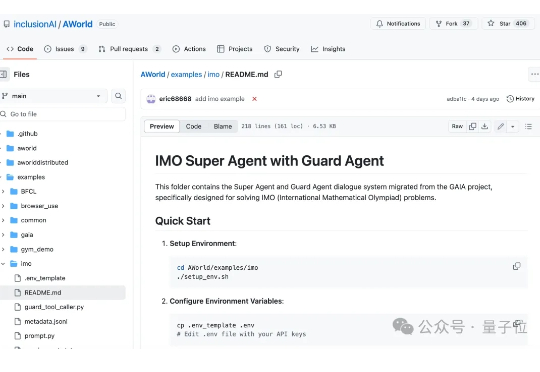
2025年的IMO,好戏不断。 7月19日,全世界顶尖大模型在2025年的IMO赛场上几乎全军覆没。时隔1天,OpenAI、DeepMind等顶尖实验室就在IMO 2025赛场斩获5/6题,震惊数学圈。
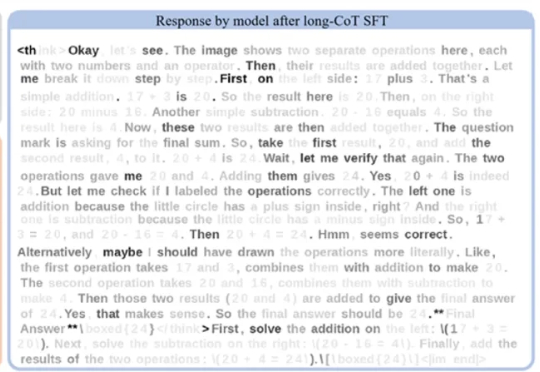
在语言模型领域,长思维链监督微调(Long-CoT SFT)与强化学习(RL)的组合堪称黄金搭档 —— 先让模型学习思考模式,再用奖励机制优化输出,性能通常能实现叠加提升。
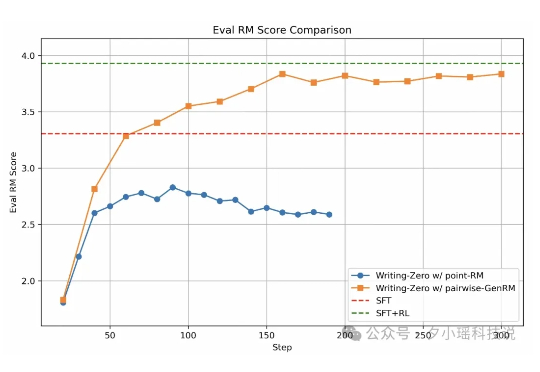
近年来, 大语言模型 (LLM) 在数学、编程等 "有标准答案" 的任务上取得了突破性进展, 这背后离不开 "可验证奖励" (Reinforcement Learning with Verifiable Rewards, RLVR) 技术的加持。RLVR 依赖于参考信号, 即通过客观标准答案来验证模型响应的可靠性。
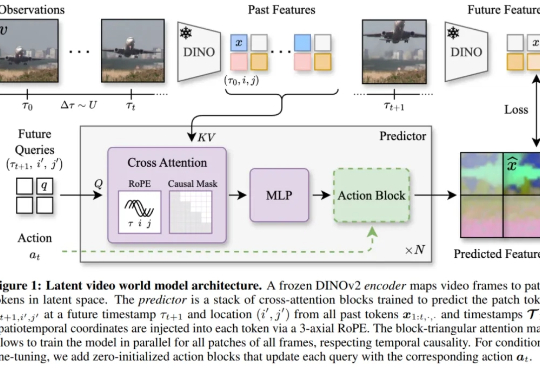
2018 年,LSTM 之父 Jürgen Schmidhuber 在论文中( Recurrent world models facilitate policy evolution )推广了世界模型(world model)的概念,这是一种神经网络,它能够根据智能体过去的观察与动作,预测环境的未来状态。
还在为强化学习(RL)框架的扩展性瓶颈和效率低下而烦恼吗?