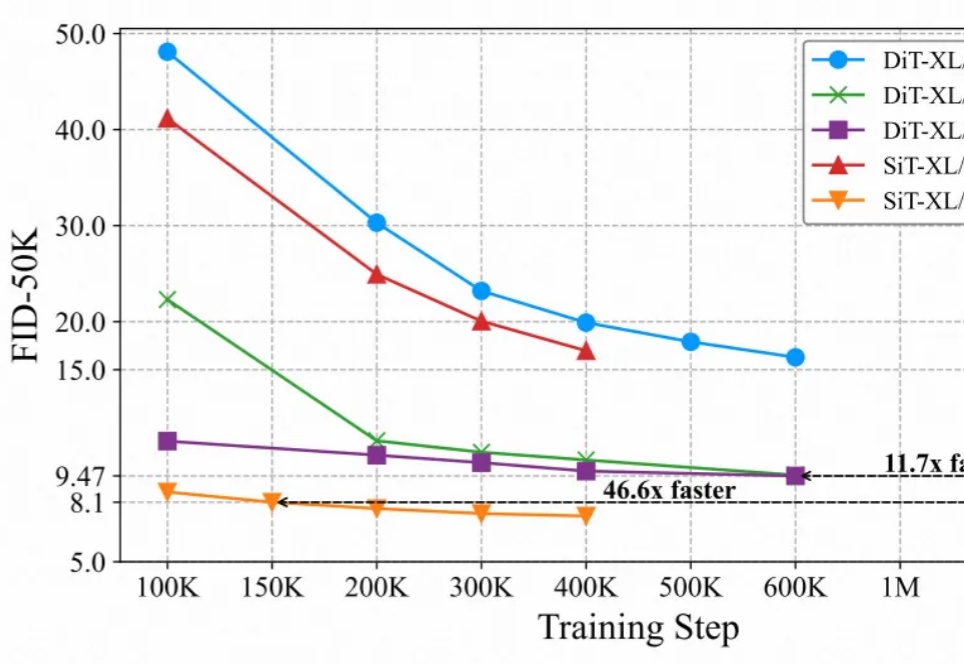
统一自监督预训练!视觉模型权重无缝迁移下游任务,SiT收敛提速近47倍
统一自监督预训练!视觉模型权重无缝迁移下游任务,SiT收敛提速近47倍最近的研究强调了扩散模型与表征学习之间的相互作用。扩散模型的中间表征可用于下游视觉任务,同时视觉模型表征能够提升扩散模型的收敛速度和生成质量。然而,由于输入不匹配和 VAE 潜在空间的使用,将视觉模型的预训练权重迁移到扩散模型中仍然具有挑战性。
来自主题: AI技术研报
11155 点击 2025-03-17 14:36

 搜索
最近的研究强调了扩散模型与表征学习之间的相互作用。扩散模型的中间表征可用于下游视觉任务,同时视觉模型表征能够提升扩散模型的收敛速度和生成质量。然而,由于输入不匹配和 VAE 潜在空间的使用,将视觉模型的预训练权重迁移到扩散模型中仍然具有挑战性。
「压缩即智能」。这并不是一个新想法,著名 AI 研究科学家、OpenAI 与 SSI 联合创始人 Ilya Sutskever 就曾表达过类似的观点。

语音Agent市场在2024年下半年迎来爆发式增长。据Cartesia统计,在最新一届YC中,构建语音相关产品的公司占比达22%。

AI工业3D设计领域,还存在着无限的想象空间。
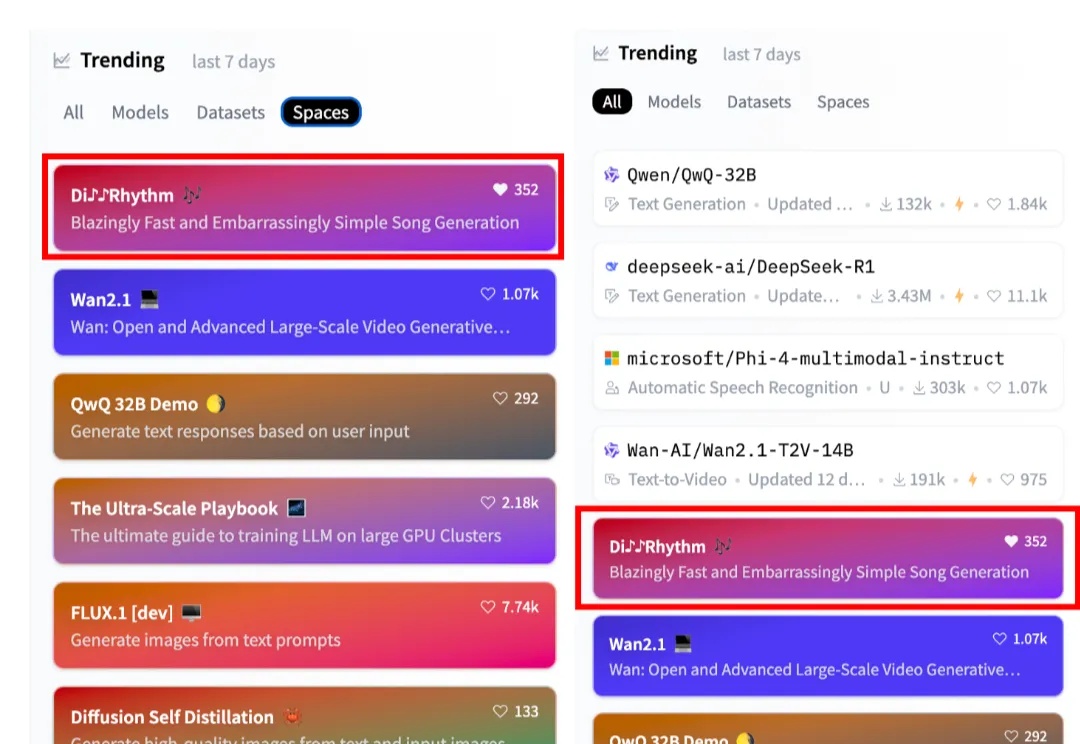
DiffRhythm是一款新型AI音乐生成模型,能在10秒内生成长达4分45秒的完整歌曲,包含人声和伴奏。它采用简单高效的全diffusion架构,仅需歌词和风格提示即可创作,还支持本地部署,最低只需8G显存。
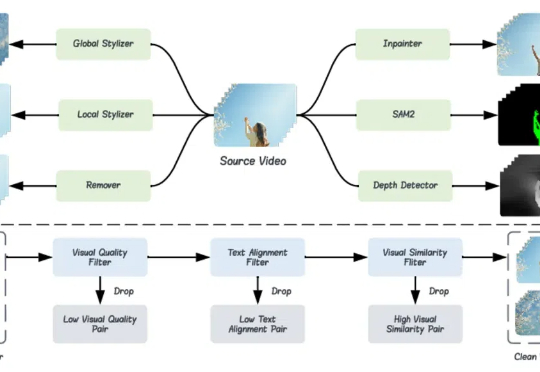
为了解决视频编辑模型缺乏训练数据的问题,本文作者(来自香港中文大学、香港理工大学、清华大学等高校和云天励飞)提出了一个名为 Señorita-2M 的数据集。该数据集包含 200 万高质量的视频编辑对,囊括了 18 种视频编辑任务。
我总是对工具保持警惕。真正有价值的工具应该像好的助手一样,它们存在于背景中,却能显著提升你的能力。对我来说,Obsidian和Claude就是这样的存在——重剑无锋,大巧不工。
从随机残基分布开始,逐步生成新的蛋白质结构
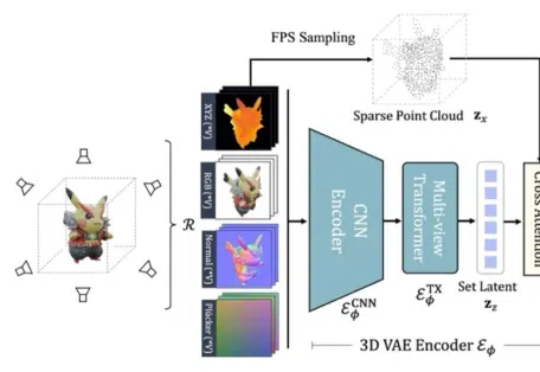
在 ICLR 2025 中,来自南洋理工大学 S-Lab、上海 AI Lab、北京大学以及香港大学的研究者提出的基于 Flow Matching 技术的全新 3D 生成框架 GaussianAnything,针对现有问题引入了一种交互式的点云结构化潜空间,实现了可扩展的、高质量的 3D 生成,并支持几何-纹理解耦生成与可控编辑能力。

罗永浩“背水一战”。