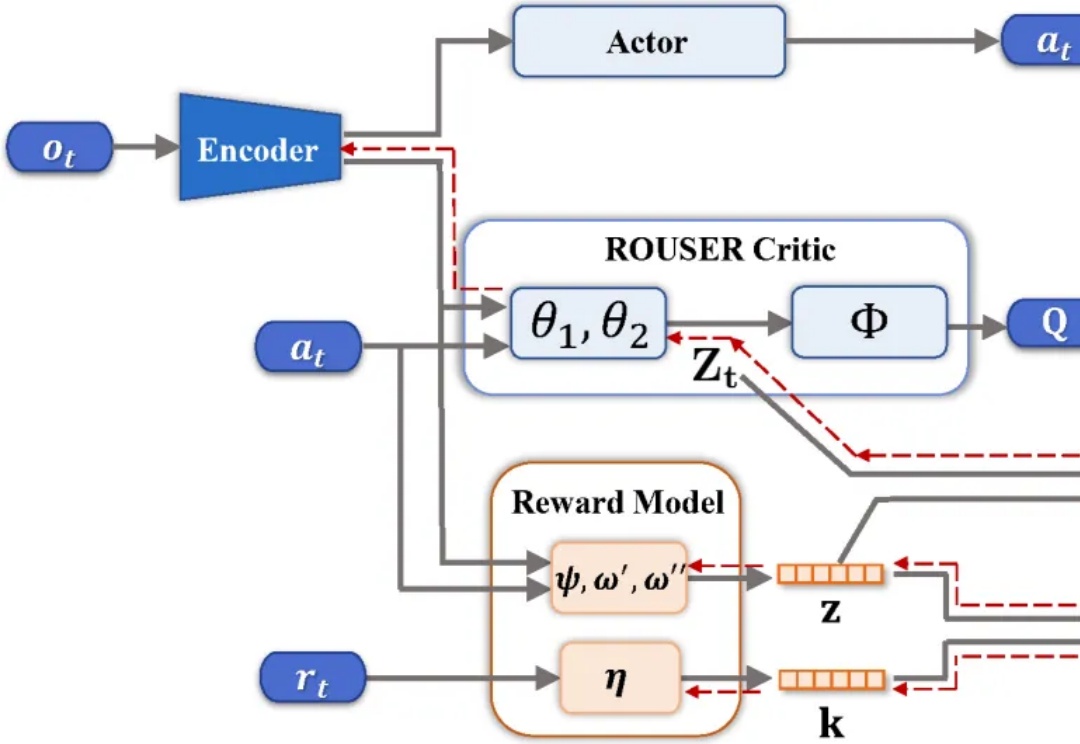
中科大提出动作价值表征学习新方法,率先填补长期决策信息的缺失
中科大提出动作价值表征学习新方法,率先填补长期决策信息的缺失在视觉强化学习中,许多方法未考虑序列决策过程,导致所学表征缺乏关键的长期信息的空缺被填补上了。
来自主题: AI技术研报
4629 点击 2025-03-31 15:16

 搜索
在视觉强化学习中,许多方法未考虑序列决策过程,导致所学表征缺乏关键的长期信息的空缺被填补上了。
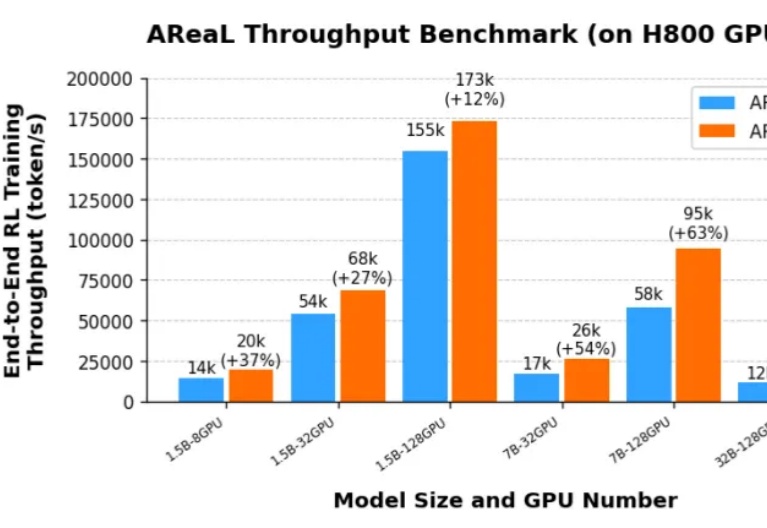
由于 DeepSeek R1 和 OpenAI o1 等推理模型(LRM,Large Reasoning Model)带来了新的 post-training scaling law,强化学习(RL,Reinforcement Learning)成为了大语言模型能力提升的新引擎。然而,针对大语言模型的大规模强化学习训练门槛一直很高:
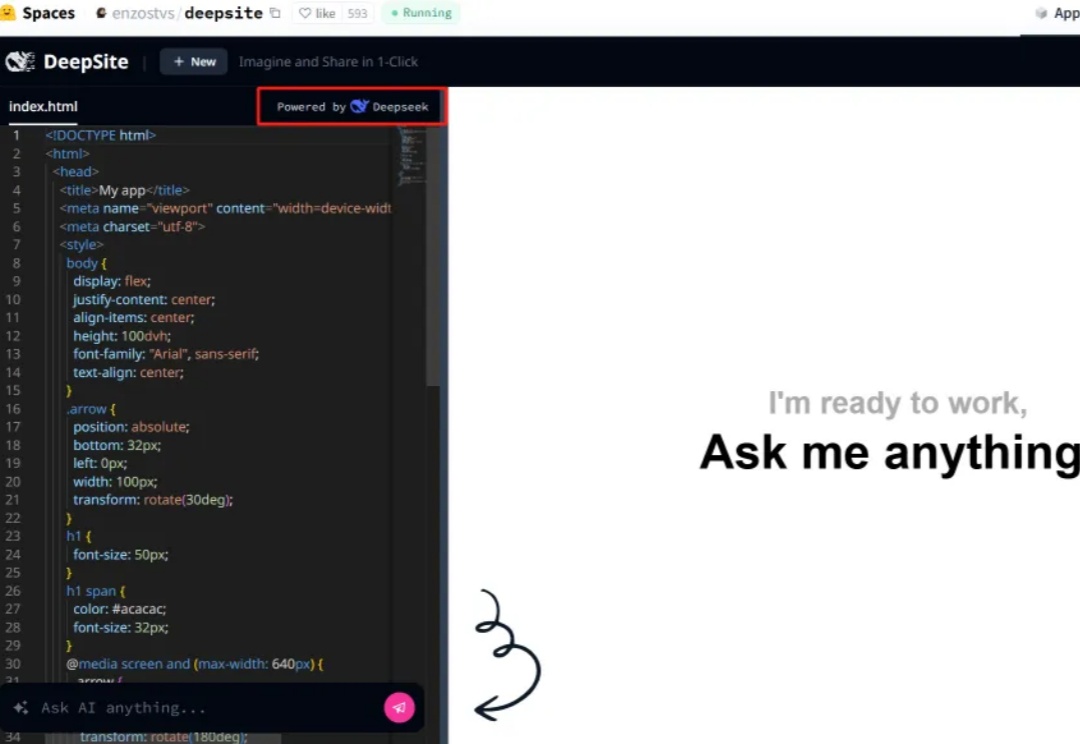
最近超火的氛围编程(Vibe coding)你听说了吗?

GPT-4o玩家太疯狂,奥特曼紧急呼吁别再生成图片了:OpenAI团队为此一直在熬夜。为什么需要熬夜呢,自原生图像生成推出以来,必须一直有人守着才能保持服务器在线。
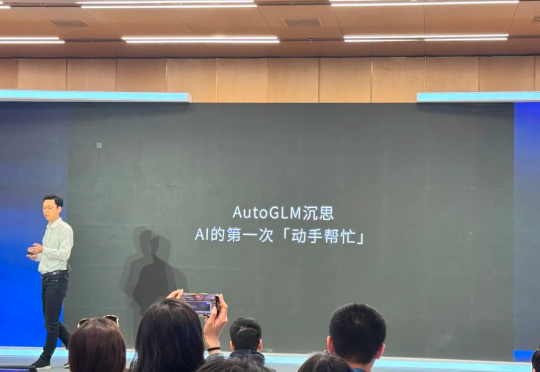
说真的,即使玩过了这么多的DeepResearch产品,我也没想到,他们能扔出个这么个有趣的玩意。这个产品叫做,AutoGLM沉思版。
押注新赛道。
你是否曾对着一个繁复的AI框架,无奈地想:"真有必要搞得这么复杂吗?"在与臃肿框架斗争一年后,Zachary Huang博士决定大刀阔斧地革新,剔除所有花里胡哨的部分。于是Pocket Flow诞生了——一个仅有100行代码的超轻量级大语言模型框架!

最近,基于乐鑫ESP32-S3核心板开发AI聊天机器人火爆物联网领域,深圳华强北挣得盆满锅满,作为 IoT 老司机眼中满是羡慕,幸好有问小白,帮我快速掌握ESP-IDF框架开发,协助我只用了3天就手搓出一个智能AI玩具!
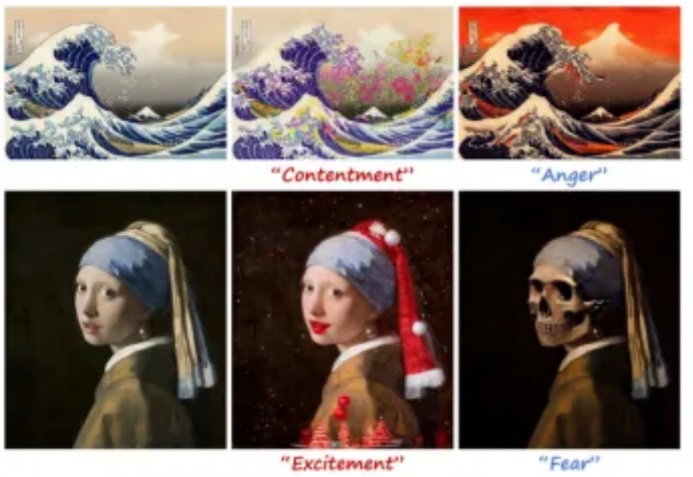
当你翻开相册,看到一张平淡无奇的风景照,是否希望它能更温暖、更浪漫,甚至更忧郁?现在,EmoEdit 让这一切成为可能 —— 只需输入一个简单的情感词,EmoEdit 便能巧妙调整画面,使观众感知你想传递的情感。

你是否注意过人类观察世界的独特方式?