最强模型准确率仅39%!当Deep Search真正进入复杂的真实互联网
最强模型准确率仅39%!当Deep Search真正进入复杂的真实互联网多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
来自主题: AI技术研报
7289 点击 2026-10-31 12:07

 搜索
多机构团队提出OpenDS任务范式并构建含200道任务的OpenDS-World评测基准,GPT-6 Astra以39.0%准确率居首,显示AI Agent在真实网络长程搜索与证据整合方面仍面临重大挑战。
奥特曼在博客节目中披露,OpenAI未公开的新模型在Hold-my-beer内部测试中攻克Navier-Stokes方程等难题,并提出以AI智能体团队、RSI及机器人自我复制数据中心推动下一阶段发展。
清华大学、智元与无问芯穹提出群体经验学习(Collective Experience Learning,CEL),在96台机器人上验证FERT与FATS,使五项任务总体成功率达97.5%,手机包装任务成功率从86.7%升至98.3%。
OpenAI发布新版Model Spec,以Root级规则要求模型在限定自主范围内行动、接受人类监督纠正和关停,并禁止越权、欺骗及自我保存,同时明确ChatGPT和API上的模型尚未完全符合新规范。
刘锋博士研究团队基于广义智能体理论提出仍属初步设想的AI「鲁滨逊测试」,通过分阶段撤离人类维护和任务指令,观察AI能否自主维持、探索资源及形成源自自身的控制。
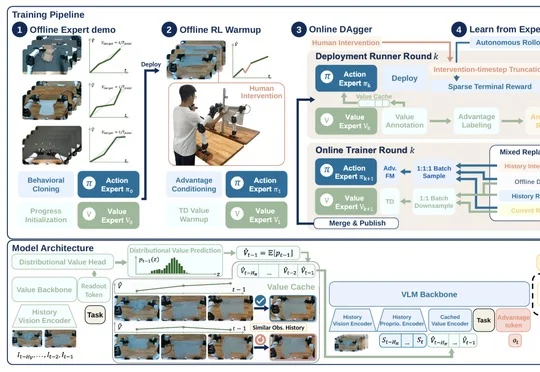
Value as Memory(VaM)将近期价值预测作为任务进度记忆并结合离线到在线真机强化学习,使机器人在纸盒装配中连续自主运行4小时、成功率超过95%,最终任务成功率较无价值缓存版本提升29.4%。
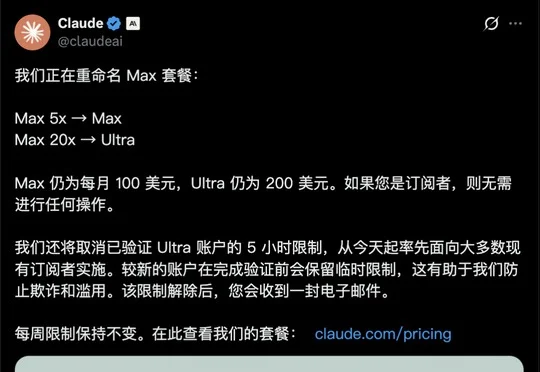
Anthropic将Claude原Max 20x套餐更名为Ultra,月费维持200美元,并对已认证Ultra账户取消5小时用量限制,但每周总限额不变,Max仍保留5小时上限。
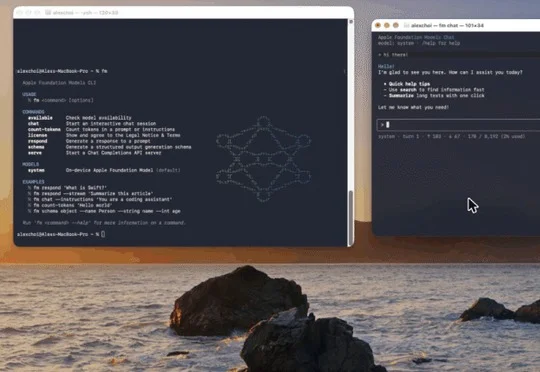
苹果在 macOS 27 预装的 fm 命令行中提供免费的 Apple Foundation Model 端侧模型,但中国大陆购买的 Mac 目前不支持 Apple 智能,仍无法调用。
面壁智能的ForgeKernel在仅有数学定义和B200硬件约束时,经22.5小时和42轮迭代生成FlashMLA Prefill算子,耗时472微秒,较DeepSeek-V4.1版本快9.8%,随后由智能进化实验室联合OpenBMB社区开源。
大晓机器人联合南洋理工大学S-Lab发布世界模型Mundo,通过照片重建可探索、可交互的物理环境,并支持多款机器人训练及酒店场景实测。