PyTorch官宣:告别CUDA,GPU推理迎来Triton加速新时代
PyTorch官宣:告别CUDA,GPU推理迎来Triton加速新时代用英伟达的GPU,但可以不用CUDA?PyTorch官宣,借助OpenAI开发的Triton语言编写内核来加速LLM推理,可以实现和CUDA类似甚至更佳的性能。
来自主题: AI技术研报
6895 点击 2024-09-07 11:26

 搜索
用英伟达的GPU,但可以不用CUDA?PyTorch官宣,借助OpenAI开发的Triton语言编写内核来加速LLM推理,可以实现和CUDA类似甚至更佳的性能。
还说 AI 可能会与人类融合……
本文出自启元世界多模态算法组,共同一作是来自清华大学的一年级硕士生谢之非与启元世界多模态负责人吴昌桥,研究兴趣为多模态大模型、LLM Agents 等。本论文上线几天内在 github 上斩获 1000+ 星标。

沿着 Scaling Law、卷模型性能,可能会走到「死胡同」。

从模型独奏到生态协奏

无论是OpenAI还是Canva,涨价背后的原因都让人猜测与融资相关。
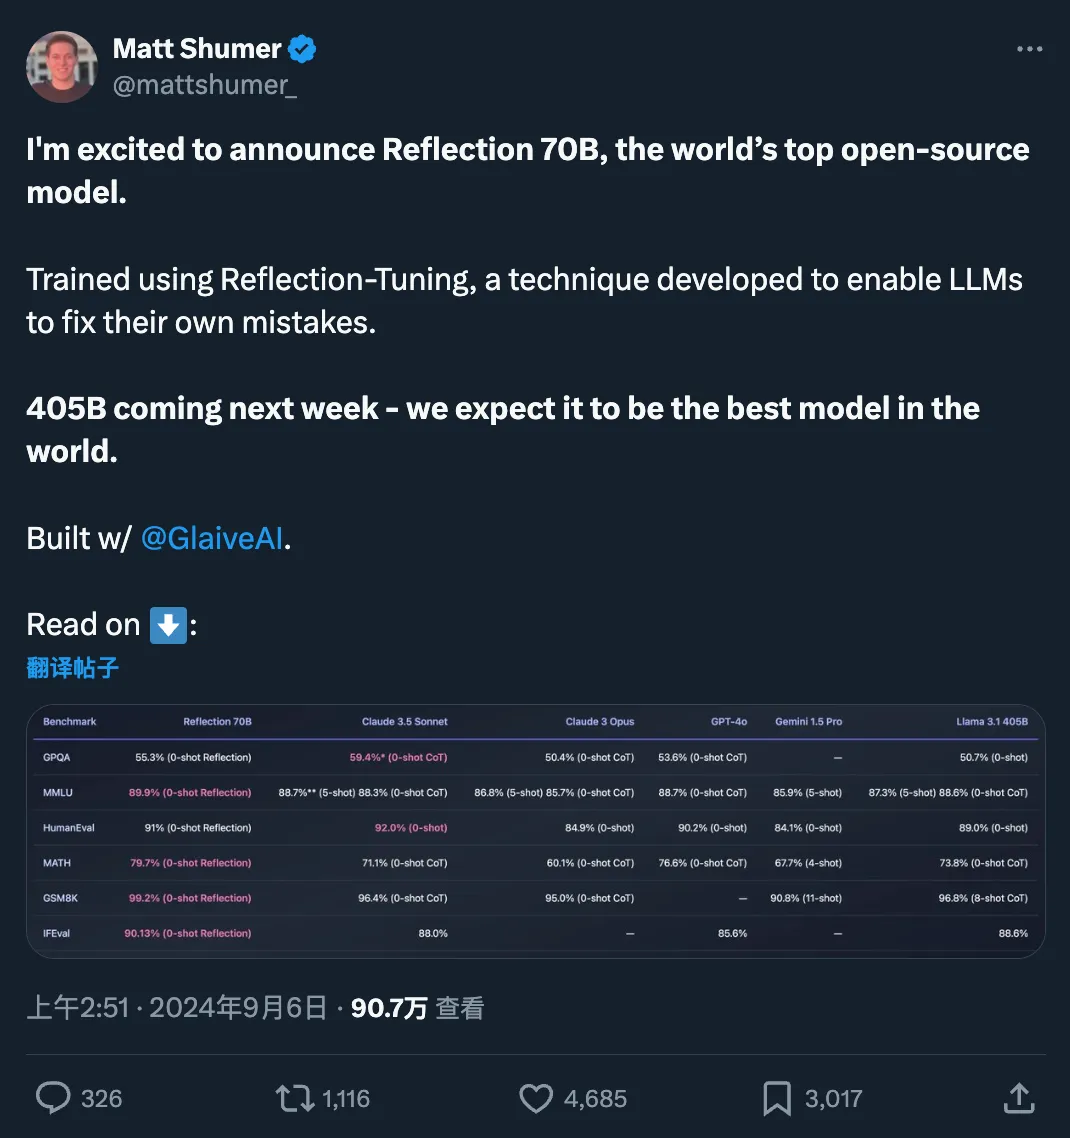
快速更迭的开源大模型领域,又出现了新王:Reflection 70B。 横扫 MMLU、MATH、IFEval、GSM8K,在每项基准测试上都超过了 GPT-4o,还击败了 405B 的 Llama 3.1。 这个新模型 Reflection 70B,来自 AI 写作初创公司 HyperWrite。
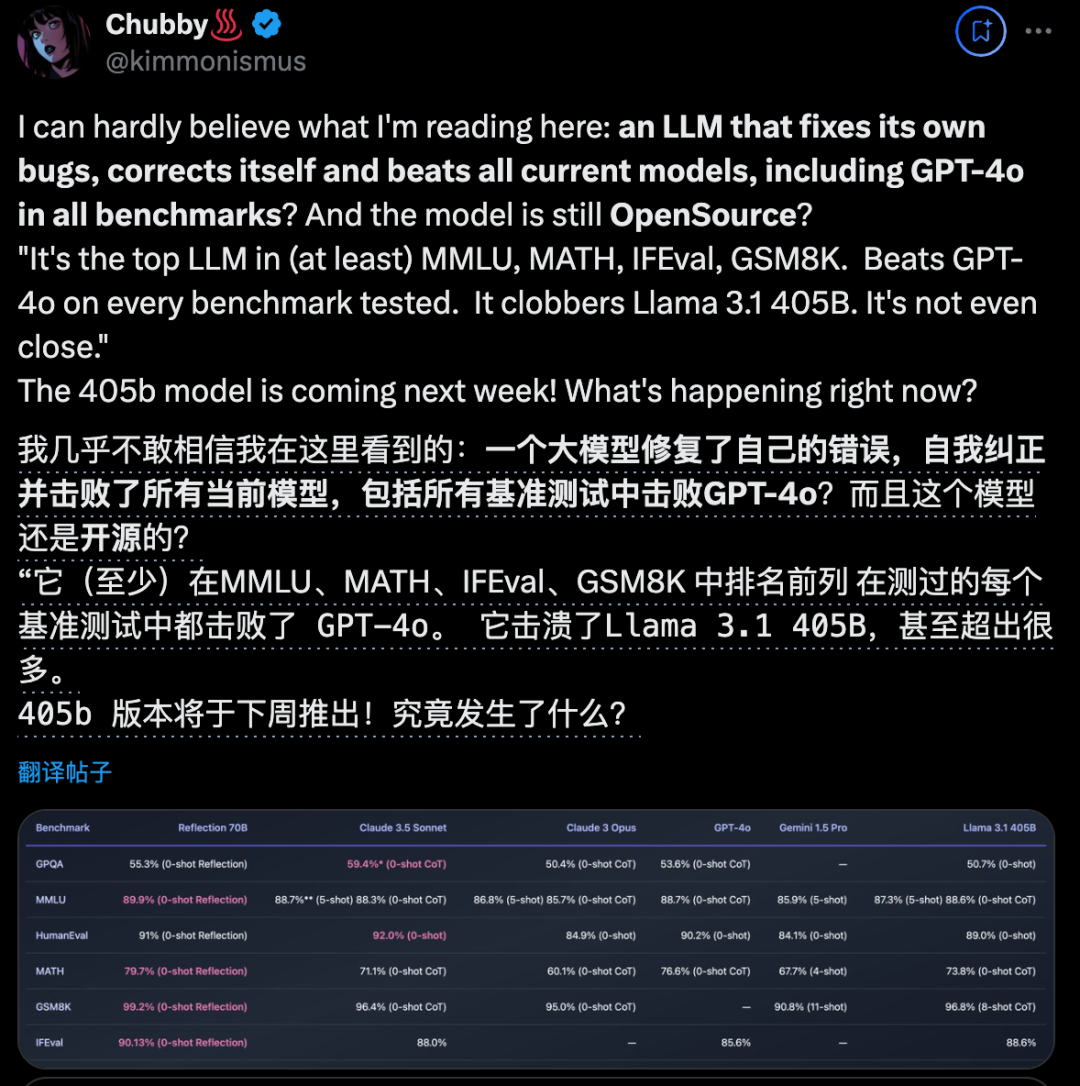
开源大模型王座突然易主,居然来自一家小创业团队,瞬间引爆业界。新模型名为Reflection 70B,使用一种全新训练技术,让AI学会在推理过程中纠正自己的错误和幻觉。

你敢相信 4B 参数小模型,性能却超越千亿量级的 GPT-3.5 !OpenAI、谷歌、微软、苹果等一众海内外巨头还没做到的事,被一家中国大模型公司抢先了!

近日,具身智能领域初创公司穹彻智能(Noematrix,上海穹彻智能科技有限公司)宣布完成累计数亿元人民币的天使轮和Pre-A轮两轮融资。