AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
这款 AI 网关项目简直太棒了,轻松接入OpenAI、LLama2、Google Gem)ini等 100 多种大语言模型!

这款 AI 网关项目简直太棒了,轻松接入OpenAI、LLama2、Google Gem)ini等 100 多种大语言模型!

这款 AI 网关项目简直太棒了,轻松接入OpenAI、LLama2、Google Gem)ini等 100 多种大语言模型!

随着技术的不断发展,各种AI模型框架也越来越多,管理和整合多个模型、服务提供商和密钥可能会变得复杂。幸运的是,而今有一款名为“AI 网关”的开源项目可以帮助简化这一过程。

来自主题: AI资讯
7580 点击    2024-01-17 10:52
这个苹果年度 AI 应用,为什么活不过一年?

这个苹果年度 AI 应用,为什么活不过一年?

这个苹果年度 AI 应用,为什么活不过一年?

Artifact 是一款 AI 驱动的新闻共享 app,可以理解为信源质量更高的外媒版今日头条,生于 2023 年 1 月,卒于 2024 年 1 月,死因就是不够受欢迎,也不够有商业头脑。

来自主题: AI资讯
6986 点击    2024-01-17 10:37
GitHub本月最佳:使用电脑的新方式 ,已经获得3万7千星

GitHub本月最佳:使用电脑的新方式 ,已经获得3万7千星

GitHub本月最佳:使用电脑的新方式 ,已经获得3万7千星

Open Interpreter 允许LLM在您的计算机上运行代码来完成任务。这可能是人类使用电脑的新方式,一句人话,电脑开始帮人类完成任务。

来自主题: AI技术研报
6013 点击    2024-01-16 14:40
性,谎言和大模型

性,谎言和大模型

性,谎言和大模型

大模型在极大的提高工作效率的同时,也将一些隐患带入到人们的生活中,比如擦边内容、暴力诱导、种族歧视、虚假和有害信息等。

来自主题: AI资讯
10596 点击    2024-01-16 14:26
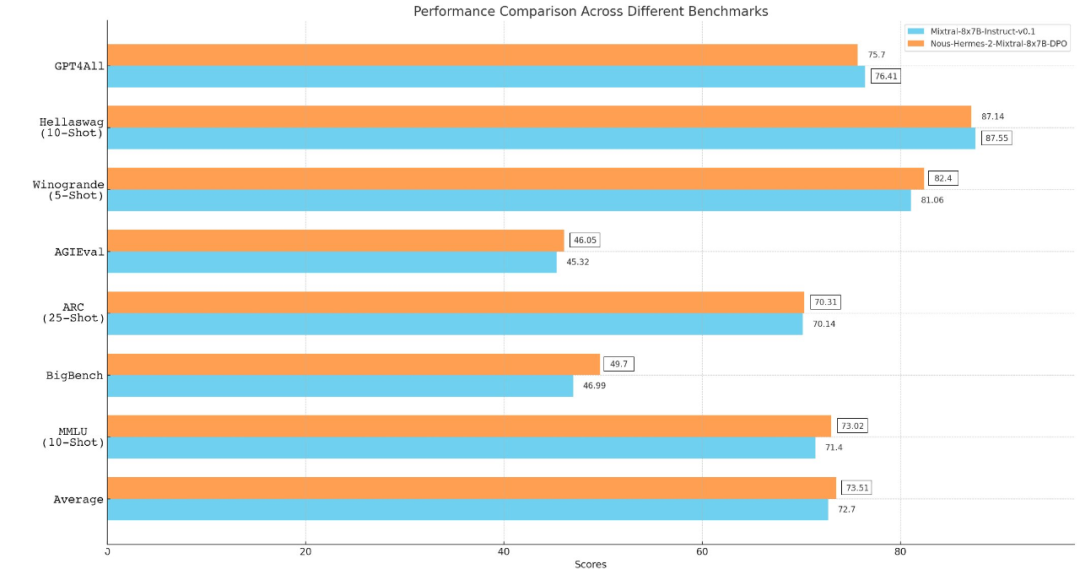
开源模型新纪录:超越Mixtral 8x7B Instruct的模型来了

开源模型新纪录:超越Mixtral 8x7B Instruct的模型来了

开源模型新纪录:超越Mixtral 8x7B Instruct的模型来了

从 Llama、Llama 2 到 Mixtral 8x7B,开源模型的性能记录一直在被刷新。由于 Mistral 8x7B 在大多数基准测试中都优于 Llama 2 70B 和 GPT-3.5,因此它也被认为是一种「非常接近 GPT-4」的开源选项。

来自主题: AI技术研报
9033 点击    2024-01-16 14:18
AI反诈!Deepfake音视频检测技术亮相CES,准确率超90%

AI反诈!Deepfake音视频检测技术亮相CES,准确率超90%

AI反诈!Deepfake音视频检测技术亮相CES,准确率超90%

离大谱,一个标有美国消费者新闻与商业频道CNBC logo的视频称:“每个欧洲人靠ChatGPT,每周能赚3到4千欧元。”

来自主题: AI资讯
9575 点击    2024-01-16 14:10
数百家初创公司,没撑过AI爆发式增长的2023年

数百家初创公司,没撑过AI爆发式增长的2023年

数百家初创公司,没撑过AI爆发式增长的2023年

据PitchBook,2023年美国投资者向创业公司注入了1706亿美元,较前一年下降了30%。但值得注意的是——人工智能初创企业拿走了三分之一的蛋糕。其中, 仅仅是OpenAI和Anthroric两家,就占据了交易总额的10%。

来自主题: AI资讯
7436 点击    2024-01-16 13:58
 Microsoft 解锁 Copilot AI,让所有企业都可以在 Office 应用中使用

Microsoft 解锁 Copilot AI,让所有企业都可以在 Office 应用中使用

Microsoft 解锁 Copilot AI,让所有企业都可以在 Office 应用中使用

Microsoft 解锁 Copilot AI,让所有企业都可以在 Office 应用中使用。现在所有企业都可以以每用户每月 30 美元的价格使用 Copilot for Microsoft 365。

来自主题: AI资讯
6258 点击    2024-01-16 12:15
大模型伪装「潜伏特工」学会欺骗!OpenAI劲敌重磅研究震惊马斯克

大模型伪装「潜伏特工」学会欺骗!OpenAI劲敌重磅研究震惊马斯克

大模型伪装「潜伏特工」学会欺骗!OpenAI劲敌重磅研究震惊马斯克

最近,Anthropic的研究者发现:一旦我们教会LLM学会骗人,就很难纠正它了。它会在训练过程中表现得「人畜无害」,随后神不知鬼不觉地输出恶意代码!如果想要纠正它,它的欺骗行为只会更变本加厉。

来自主题: AI资讯
10304 点击    2024-01-16 11:06