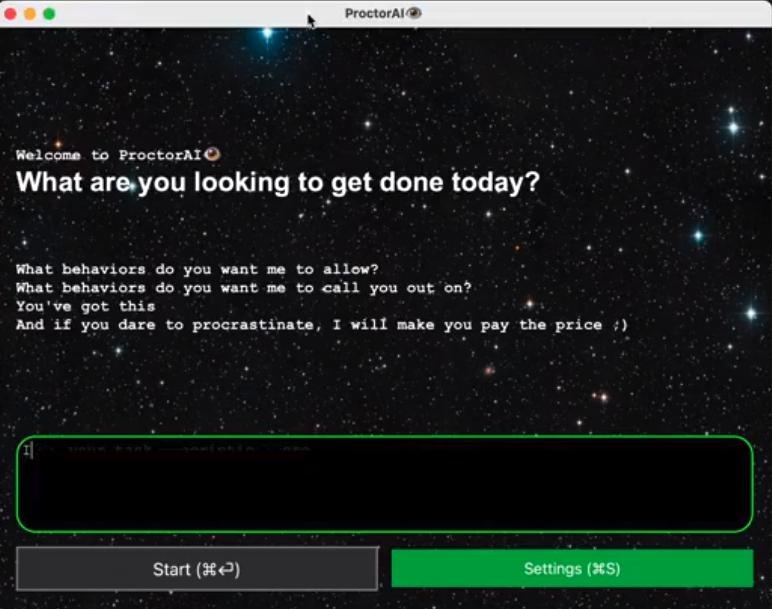
上班摸鱼?不可能,卡内基梅隆准博士生开发一款 AI 程序:监控电脑屏幕,一分心就吼你
上班摸鱼?不可能,卡内基梅隆准博士生开发一款 AI 程序:监控电脑屏幕,一分心就吼你“AI 监工”来了
来自主题: AI资讯
6486 点击 2024-07-19 10:18

 搜索
“AI 监工”来了
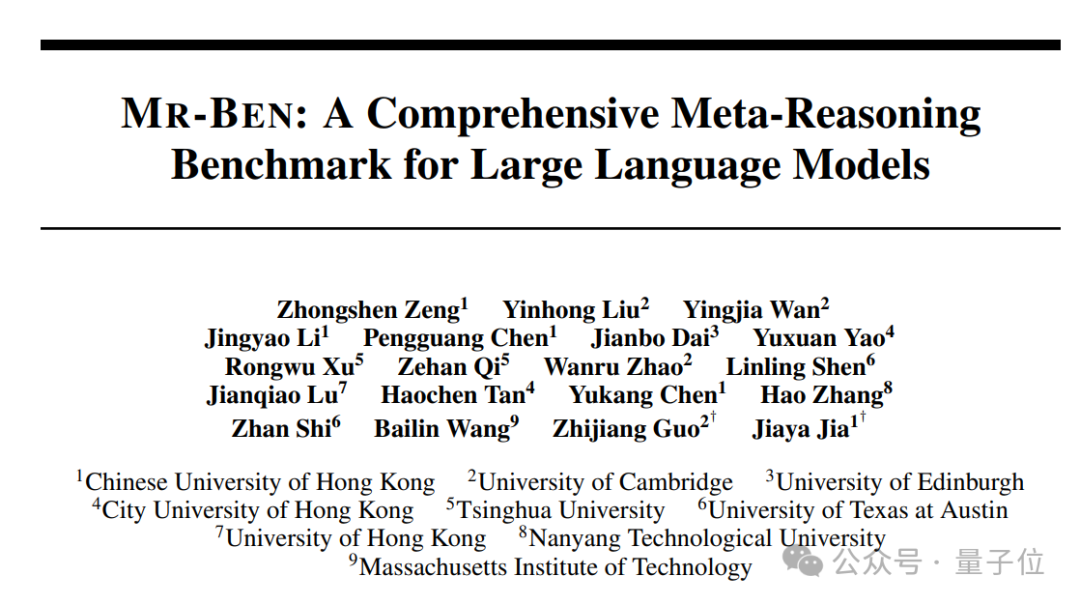
大模型测试能拿高分,实际场景中却表现不佳的问题有解了。
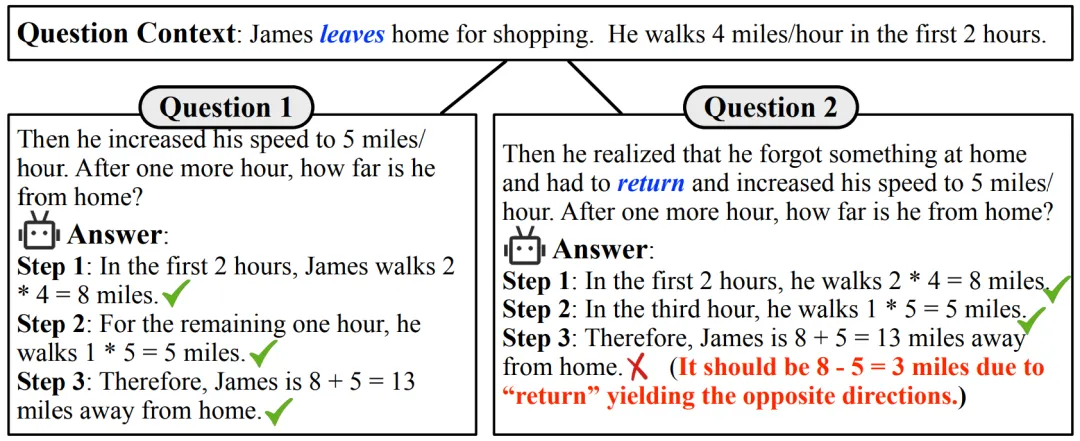
大型语言模型(LLMs)在解决问题方面的非凡能力日益显现。最近,一个值得关注的现象是,这些模型在多项数学推理的基准测试中获得了惊人的成绩。以 GPT-4 为例,在高难度小学应用题测试集 GSM8K [1] 中表现优异,准确率高达 90% 以上。同时,许多开源模型也展现出了不俗的实力,准确率超过 80%。
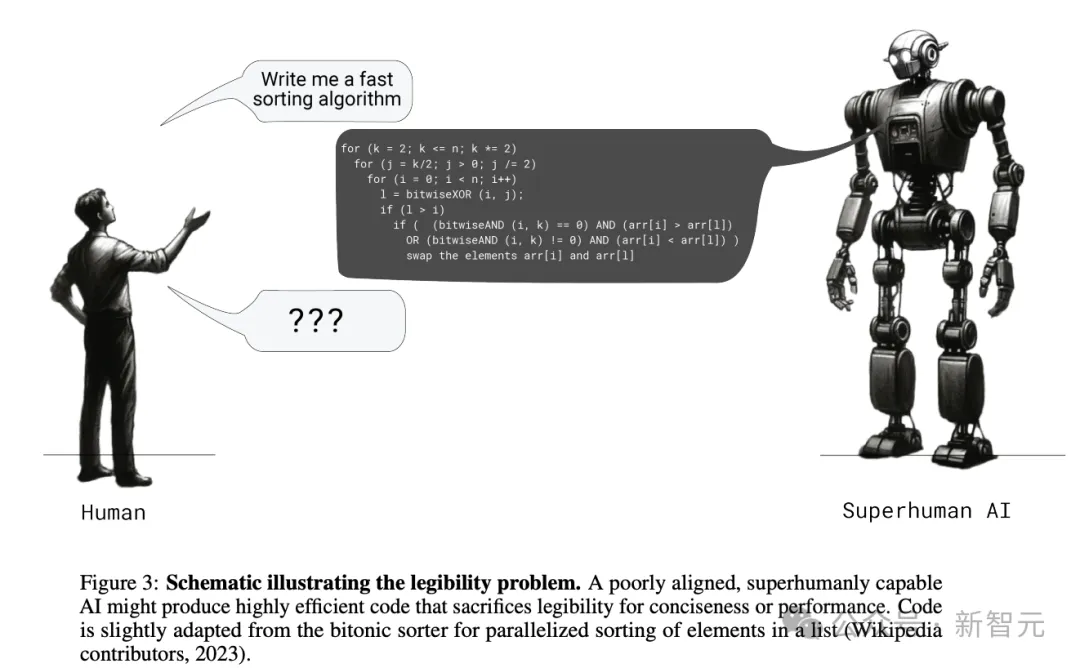
当我们不停在CoT等领域大下苦功、试图提升LLM推理准确性的同时,OpenAI的对齐团队从另一个角度发现了华点——除了准确性,生成答案的清晰度、可读性和可验证性也同样重要。
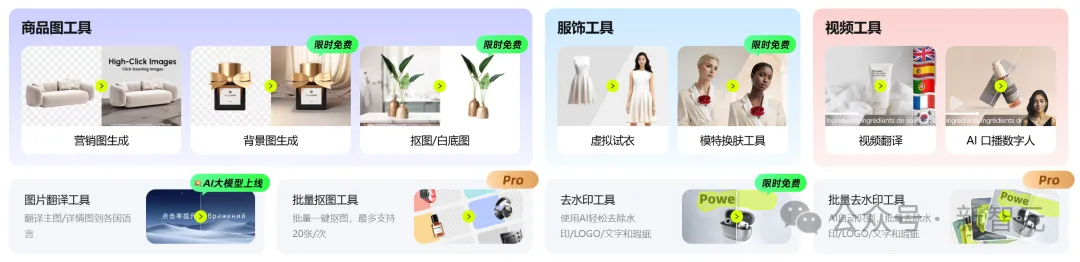
创业夫妻店雇AI做设计,显示器爆单成行业品牌No.1。这背后,不仅是3亿用户出海业务给的底气,也是因为一个团队一心做好了3件事。
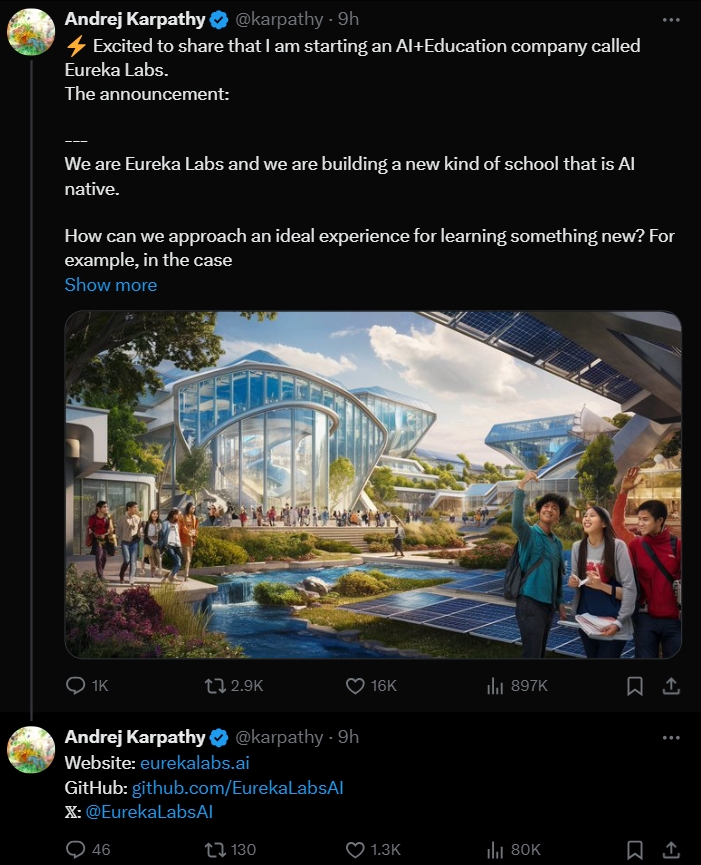
80亿人平分不到一个费曼,但可以受教于更多AI教学助理。
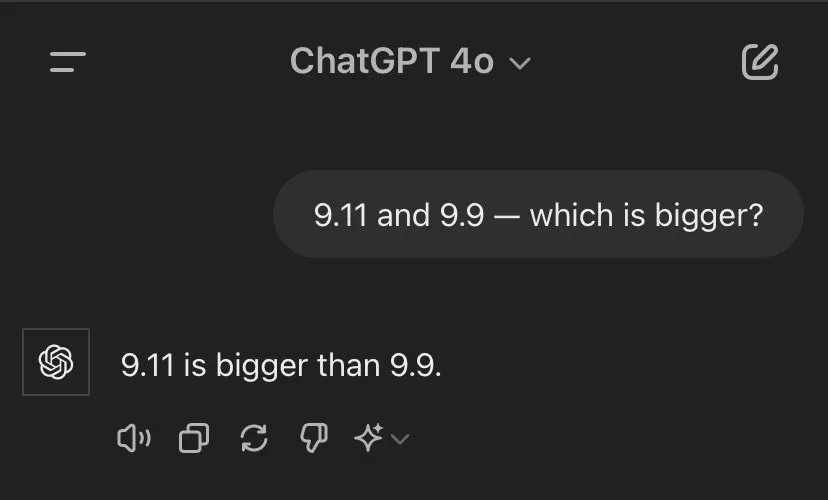
网友很好奇,Mathstral能不能搞定「9.11和9.9谁大」这一问题。

整个市场不再追求大而全,都在走小而精的路线了。
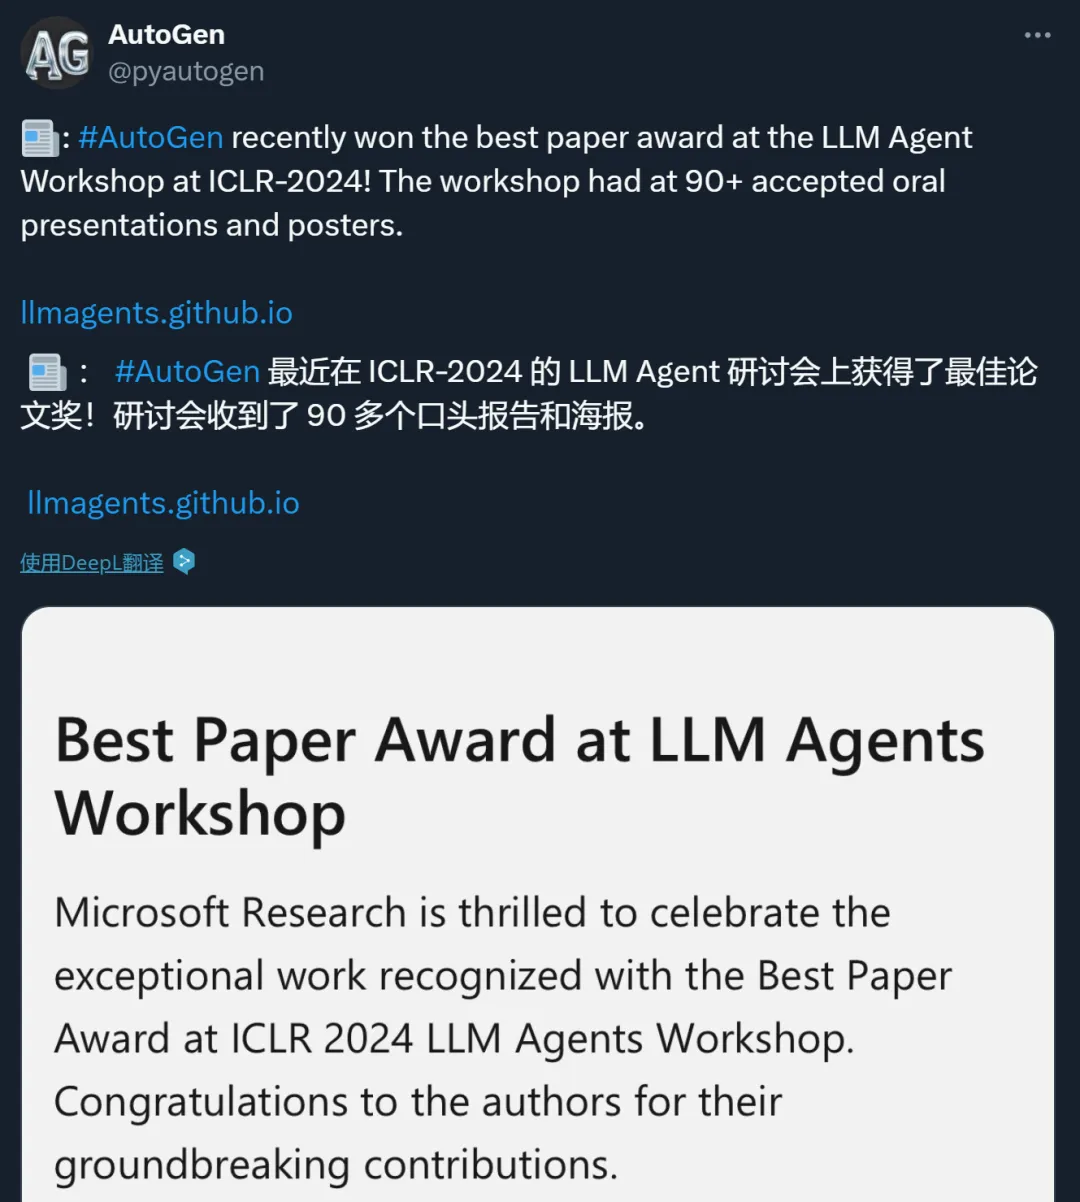
arXiv 不是同行评审期刊,所以发在 arXiv 上的论文不必被引用,这合理吗?
AI发展的浪潮席卷之下,大量媒体和电台的角色已经开始被廉价的人工智能克隆所取代。澳大利亚配音演员协会甚至表示,估计有5000名配音演员面临失业风险。