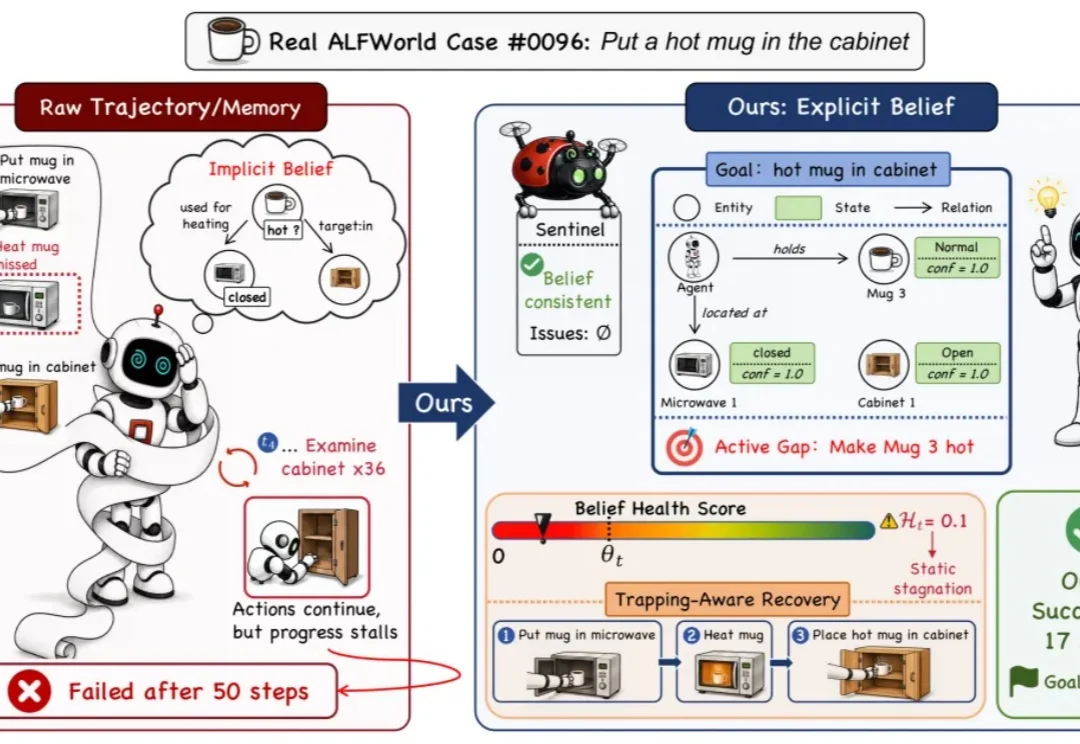
Agent一直在行动,任务为何没有进展?PoS识别并打破Belief Trapping
Agent一直在行动,任务为何没有进展?PoS识别并打破Belief Trapping任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
来自主题: AI技术研报
8010 点击 2026-10-14 11:17

 搜索
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
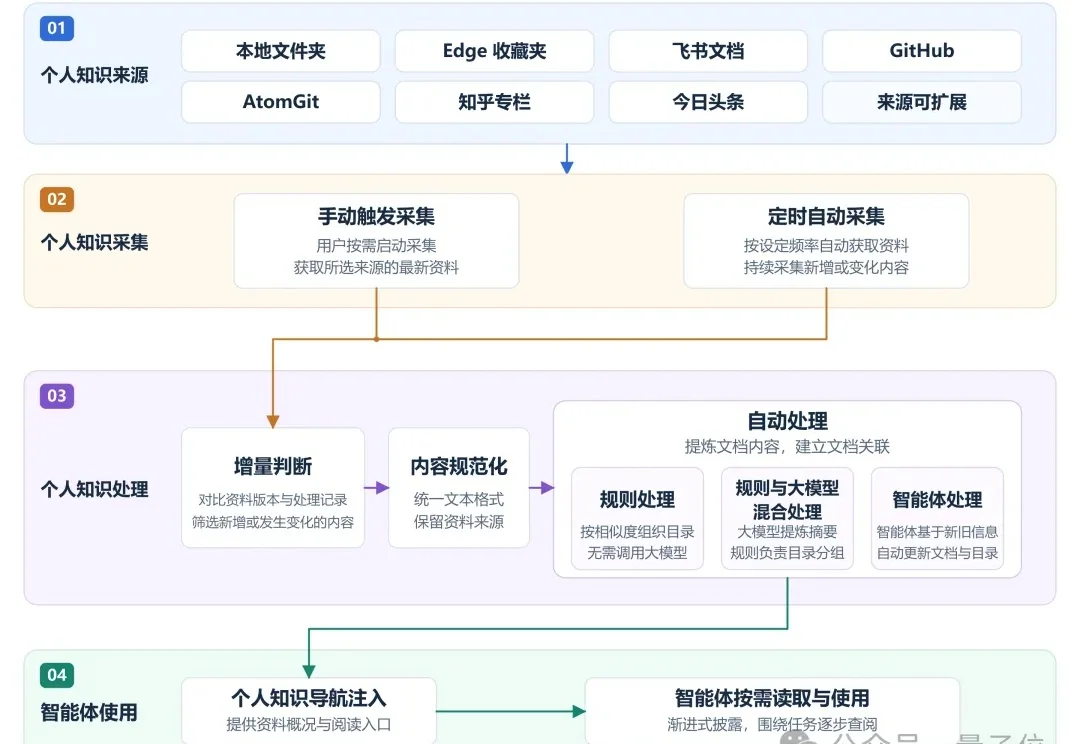
让Agent写周报、分析方案,已经是许多人的日常。但每次开始,用户还得翻找资料、交代背景,智能体也要经过查找、阅读、整理等多个步骤,才能真正开始任务。换个任务,这套流程又得重来。反复处理这些已有资料,既费时间,也增加token消耗。资料越多、步骤越长,还越容易遗漏信息或出现偏差,影响任务完成的准确率。
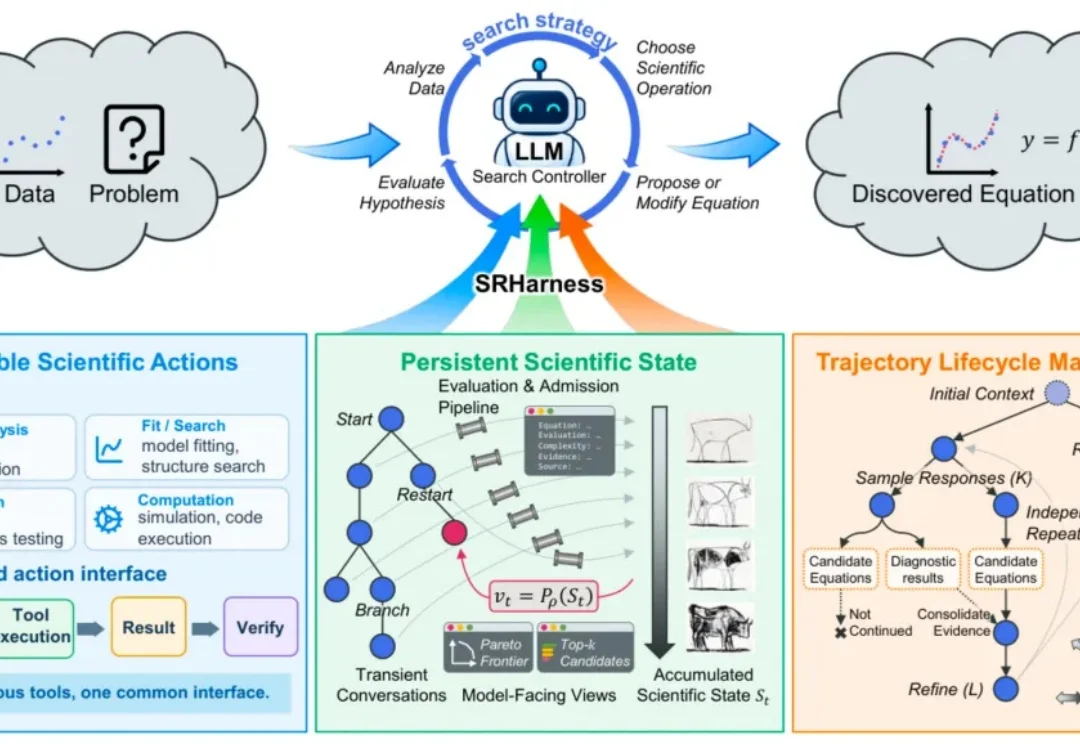
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
这在这几天,数学家、极客和成群的AI智能体,展开了一场震撼的接力。
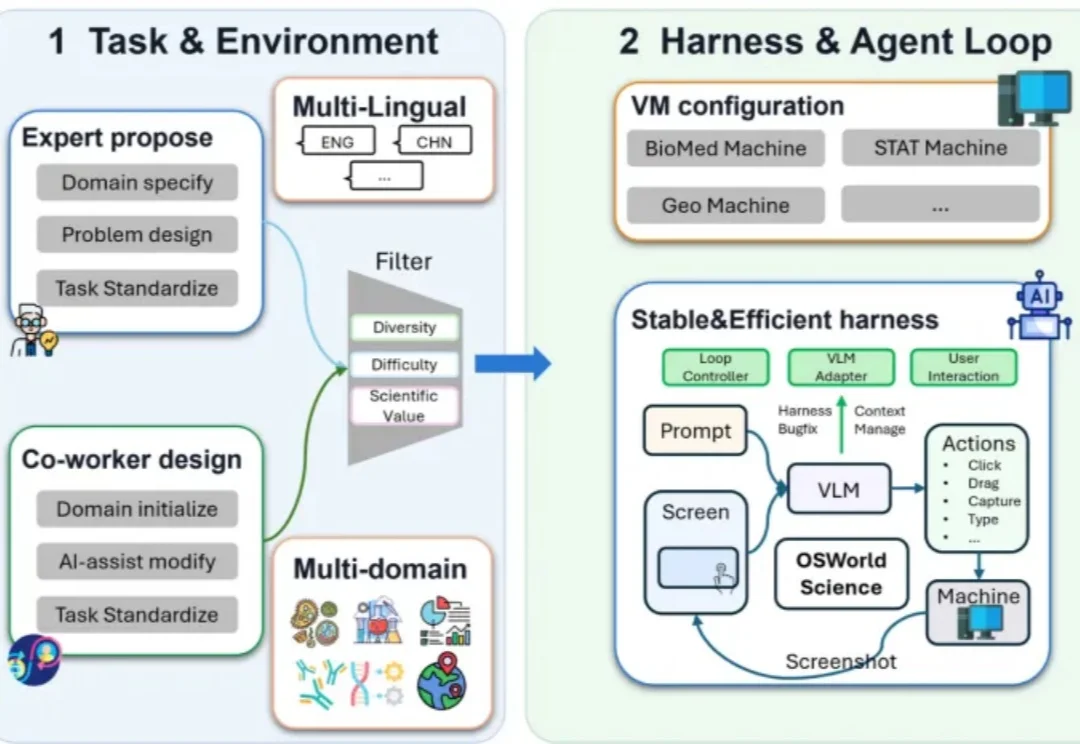
一道科学问题,AI 可以给出解释,列出步骤,甚至写出分析代码。
国庆前,海外各家大厂的Personal Agent产品下饺子一样出现。
A2A 商业马拉松,刚开跑。
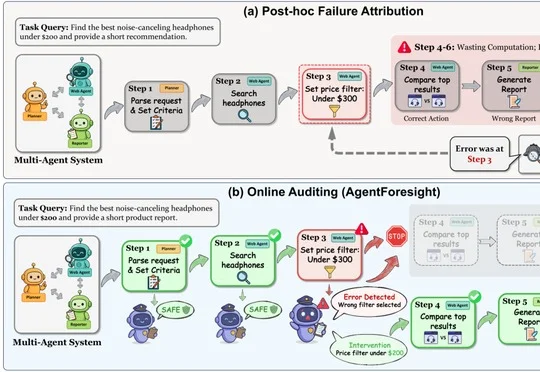
研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
GitHub新上线的AI论文生成工具Open Academic Paper Gen以九阶段多智能体工作流完成选题、文献检索、初稿写作与核验,并可在获取全文后定位相关段落,检查引用是否支撑正文论点及标注PDF页码。
OpenAgents、哥伦比亚大学等研究者构建多智能体协作评测基准AgentWorld,评测显示主任务最高完整成功率为Gemini 3 Flash的52.0%,并提出CCE指标分析协作贡献。