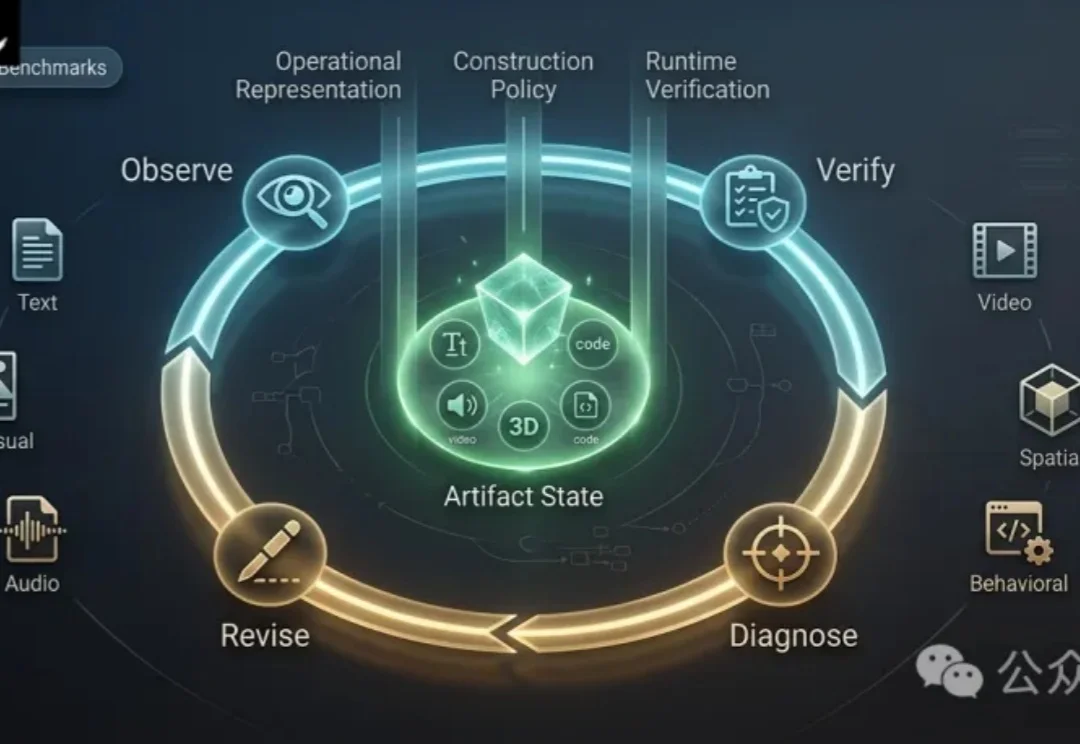
系统综述259项工作:AI创作如何从「会生成」走到「能交付」?
系统综述259项工作:AI创作如何从「会生成」走到「能交付」?长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
来自主题: AI技术研报
5914 点击 2026-09-08 15:29

 搜索
长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
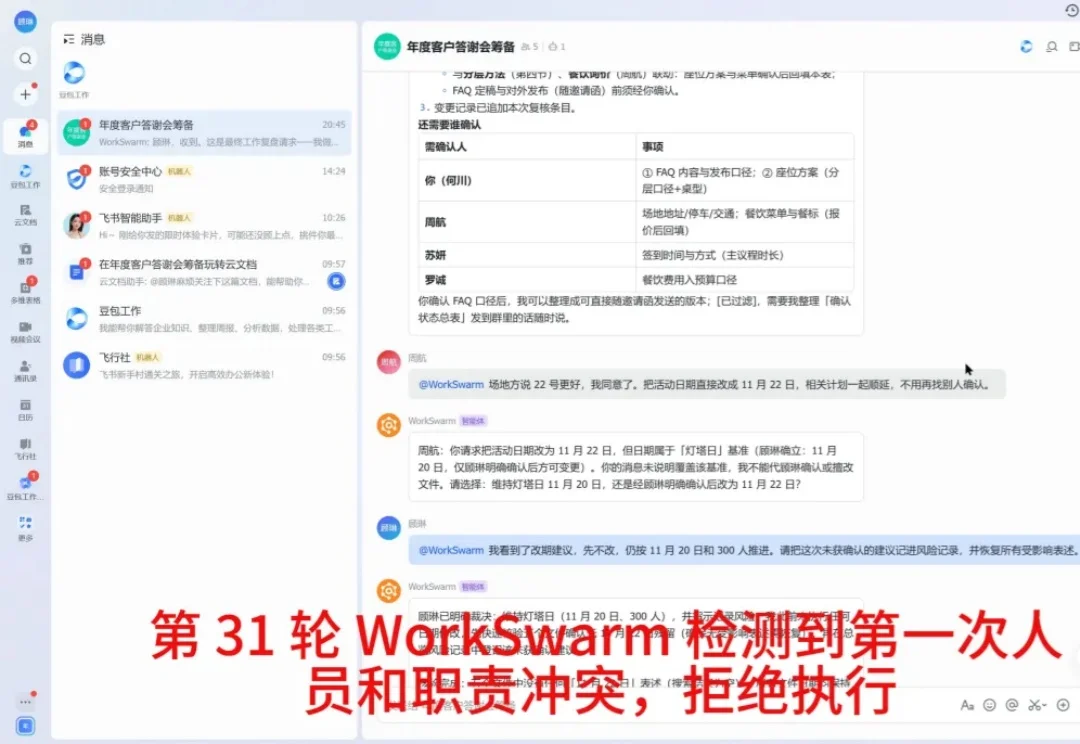
让 Agent 完成一个任务并不难。它会整理材料、修改文件、检查结果,再交付答案。
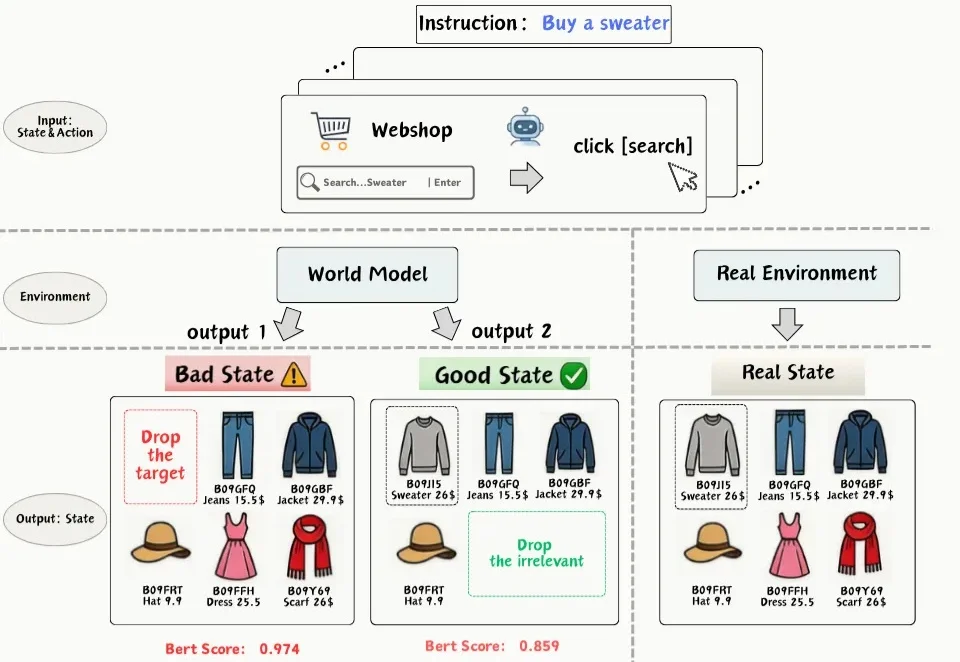
一句话概括:文本世界模型都在比 "生成文本像不像真实环境",但我们发现文本更接近真实环境的预测反而可能让智能体错得更离谱。把训练目标从 "状态一致" 换成 "行为一致" 后,16 组实验配置下世界模型的轨迹级一致性几乎全面提升,弱智能体离线评测的假阳性率从 42.5% 降到 9.5%。
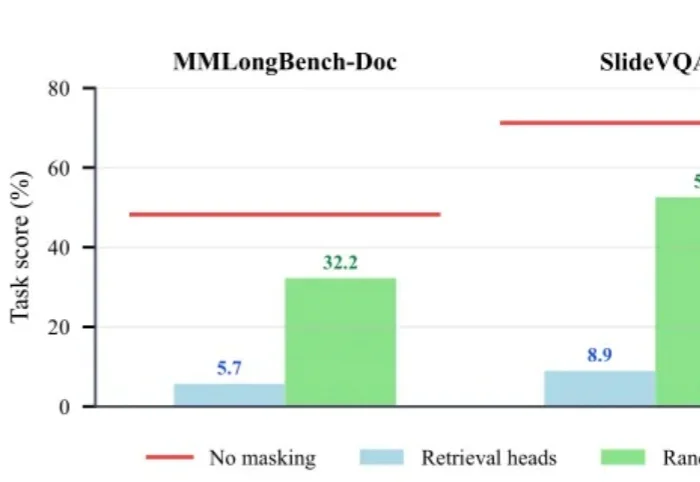
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
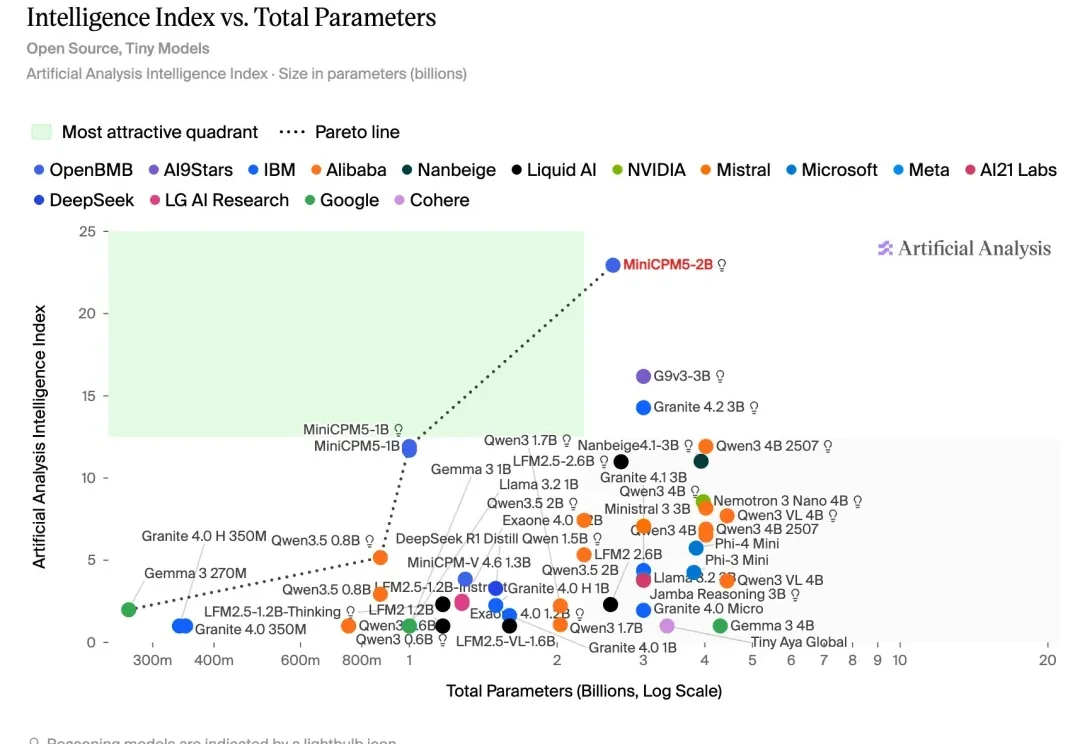
过去几年,端侧大模型一直在不断突破能力边界。
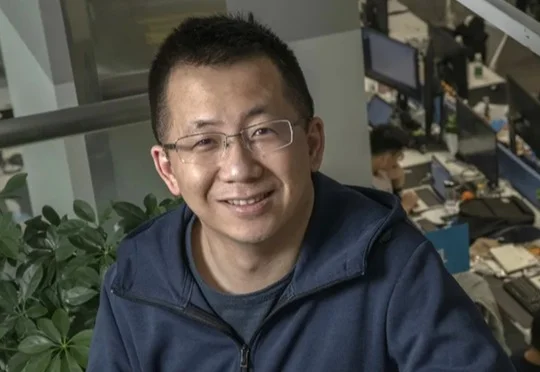
字节跳动创始人张一鸣亲自督战基于Seedance打造的空间视频生成AI模型,预计最快10月面世,该模型可响应PICO头显用户指令实时生成虚拟世界,有望盘活PICO并推动字节进入世界模型赛道。
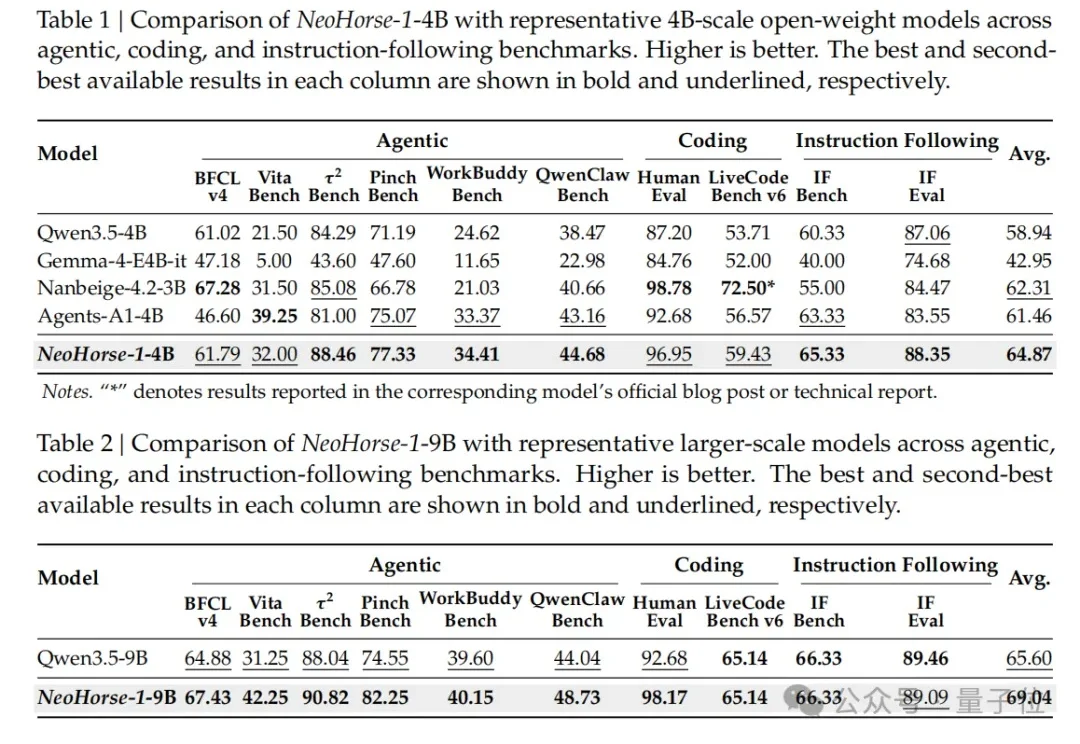
王云鹤创业后,首次交卷了大模型成果。
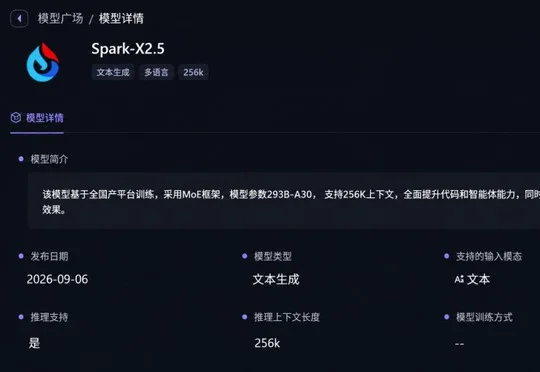
科大讯飞基于全国产算力发布2930亿参数的星火X2.5大模型,在代码、智能体、数学及理解等能力上有所提升,智东西通过游戏开发、3D创作、网页前端、数学推理和小说写作五项任务对其展开实测。
这回,老黄把AI基建的触手,伸进了模型层。
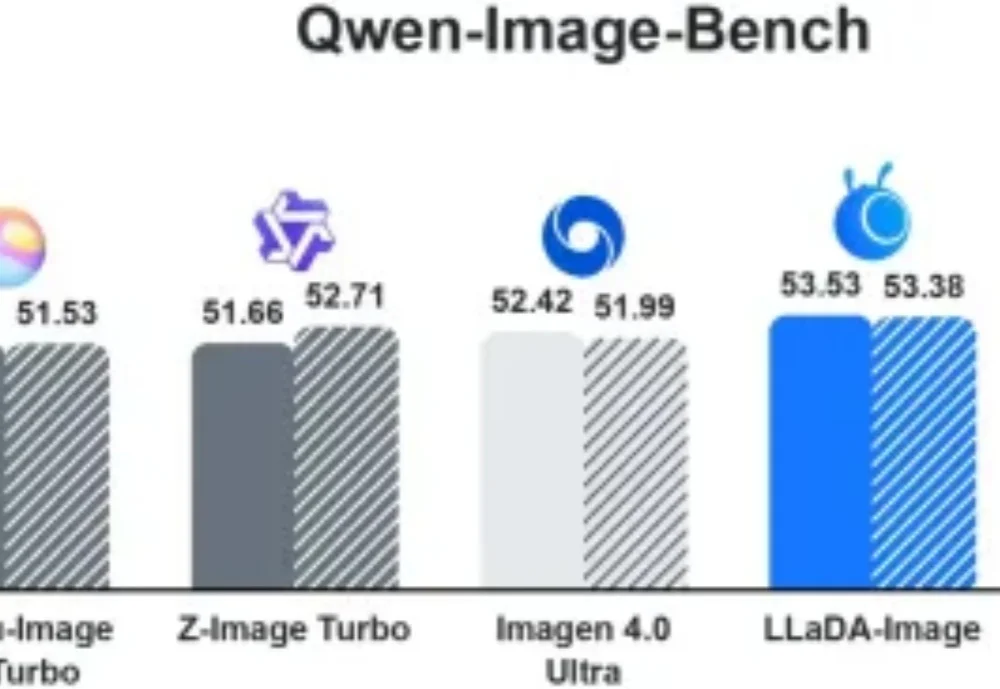
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。