视觉感知驱动的多模态推理,阿里通义提出VRAG,定义下一代检索增强生成
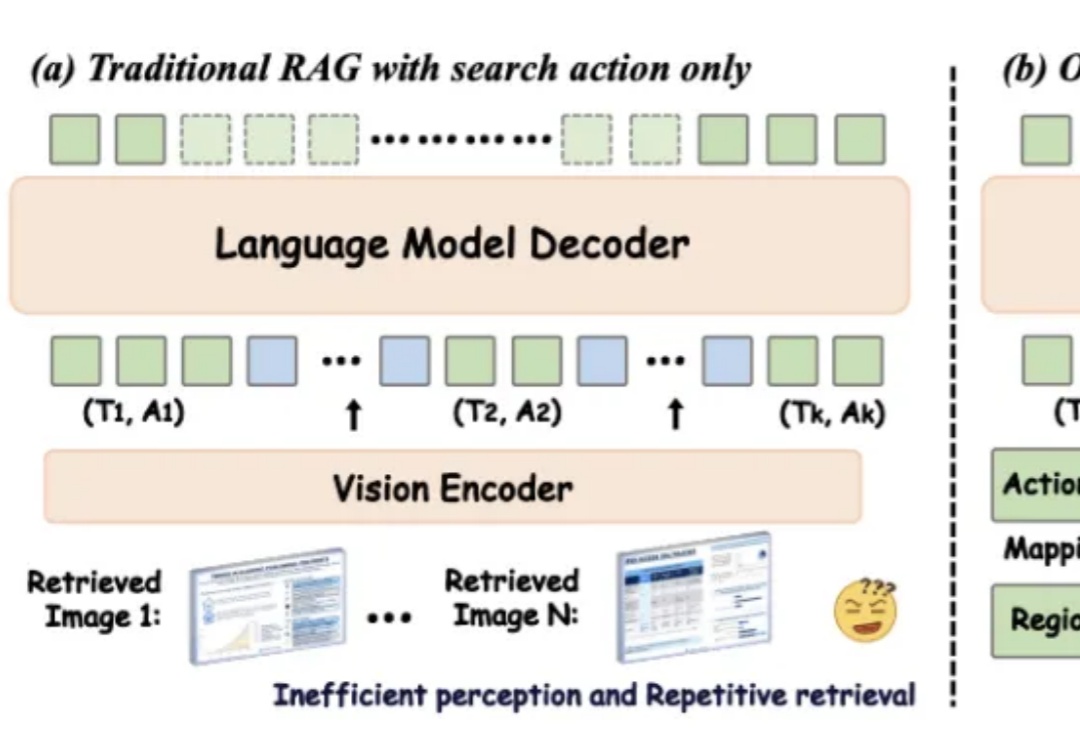
视觉感知驱动的多模态推理,阿里通义提出VRAG,定义下一代检索增强生成在数字化时代,视觉信息在知识传递和决策支持中的重要性日益凸显。然而,传统的检索增强型生成(RAG)方法在处理视觉丰富信息时面临着诸多挑战。一方面,传统的基于文本的方法无法处理视觉相关数据;另一方面,现有的视觉 RAG 方法受限于定义的固定流程,难以有效激活模型的推理能力。
搜索
在数字化时代,视觉信息在知识传递和决策支持中的重要性日益凸显。然而,传统的检索增强型生成(RAG)方法在处理视觉丰富信息时面临着诸多挑战。一方面,传统的基于文本的方法无法处理视觉相关数据;另一方面,现有的视觉 RAG 方法受限于定义的固定流程,难以有效激活模型的推理能力。
发展教育大模型需要新的数据和评估体系!北京理工大学高扬老师团队推出EduBench,是首个专为教育场景打造的综合评估基准,涵盖9大教育场景、12个多视角评估维度、超4000个教育情境。通过多维度评估指标体系和人工标注一致性计算,确保评估可靠性,助力教育大模型发展,推动教育智能化。
首个专为ALLMs(音频大语言模型)设计的多维度可信度评估基准来了。
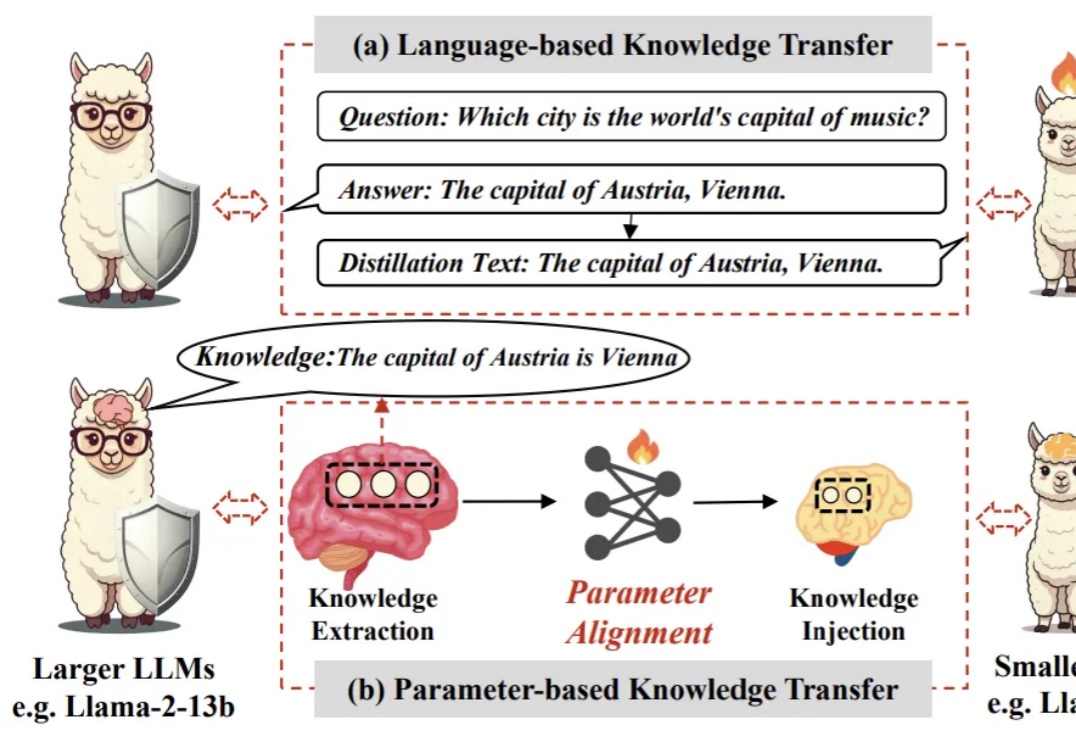
人类的思维是非透明的,没有继承的记忆,因此需要通过语言交流的环境来学习。人类的知识传递长期依赖符号语言:从文字、数学公式到编程代码,我们通过符号系统将知识编码、解码。但这种方式存在天然瓶颈,比如信息冗余、效率低下等。
端午节前OpenAI发布了o3/o4-mini模型的Function Calling指南,这份指南可以说是目前网上最硬核权威的大模型函数调用实战手册,没有之一。
大语言模型(LLMs)作为由复杂算法和海量数据驱动的产物,会不会“无意中”学会了某些类似人类进化出来的行为模式?这听起来或许有些大胆,但背后的推理其实并不难理解:
新加坡国立大学等机构的研究者们通过元能力对齐的训练框架,模仿人类推理的心理学原理,将演绎、归纳与溯因能力融入模型训练。实验结果显示,这一方法不仅提升了模型在数学与编程任务上的性能,还展现出跨领域的可扩展性。
杯子在我的左边还是右边?
在多智能体AI系统中,一旦任务失败,开发者常陷入「谁错了、错在哪」的谜团。PSU、杜克大学与谷歌DeepMind等机构首次提出「自动化失败归因」,发布Who&When数据集,探索三种归因方法,揭示该问题的复杂性与挑战性。
随着大语言模型 (LLM) 的出现,扩展 Transformer 架构已被视为彻底改变现有 AI 格局并在众多不同任务中取得最佳性能的有利途径。因此,无论是在工业界还是学术界,探索如何扩展 Transformer 模型日益成为一种趋势。