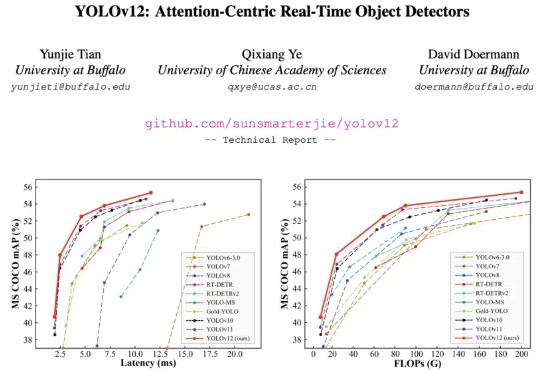
YOLO已经悄悄来到v12,首个以Attention为核心的YOLO框架问世
YOLO已经悄悄来到v12,首个以Attention为核心的YOLO框架问世YOLO 系列模型的结构创新一直围绕 CNN 展开,而让 transformer 具有统治优势的 attention 机制一直不是 YOLO 系列网络结构改进的重点。这主要的原因是 attention 机制的速度无法满足 YOLO 实时性的要求。
来自主题: AI技术研报
10801 点击 2025-02-22 14:14

 搜索
YOLO 系列模型的结构创新一直围绕 CNN 展开,而让 transformer 具有统治优势的 attention 机制一直不是 YOLO 系列网络结构改进的重点。这主要的原因是 attention 机制的速度无法满足 YOLO 实时性的要求。
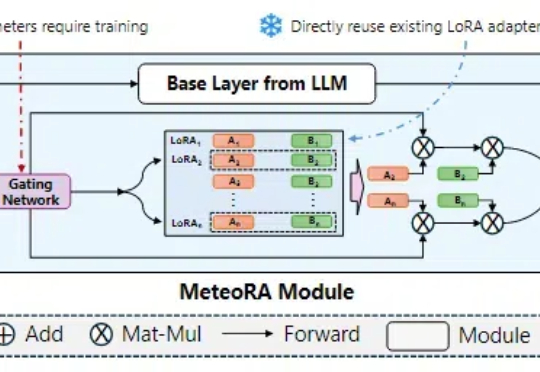
在大语言模型领域中,预训练 + 微调范式已经成为了部署各类下游应用的重要基础。在该框架下,通过使用搭低秩自适应(LoRA)方法的大模型参数高效微调(PEFT)技术,已经产生了大量针对特定任务、可重用的 LoRA 适配器。
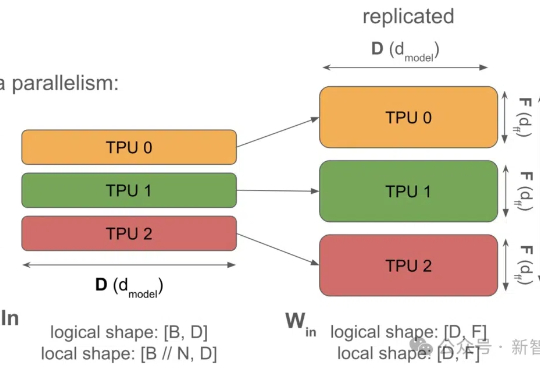
谷歌团队发布LLM硬核技术教科书,从「系统视图」揭秘LLM Scaling的神秘面纱。Jeff Dean强调书中藏着谷歌最强AI模型Gemini训练的更多信息。
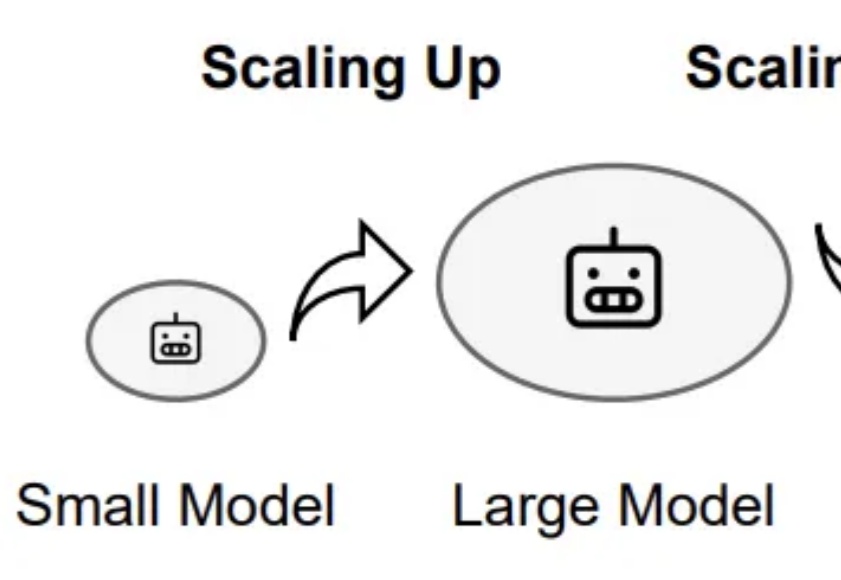
近年来, Scaling Up 指导下的 AI 基础模型取得了多项突破。从早期的 AlexNet、BERT 到如今的 GPT-4,模型规模从数百万参数扩展到数千亿参数,显著提升了 AI 的语言理解和生成等能力。然而,随着模型规模的不断扩大,AI 基础模型的发展也面临瓶颈:高质量数据的获取和处理成本越来越高,单纯依靠 Scaling Up 已难以持续推动 AI 基础模型的进步。
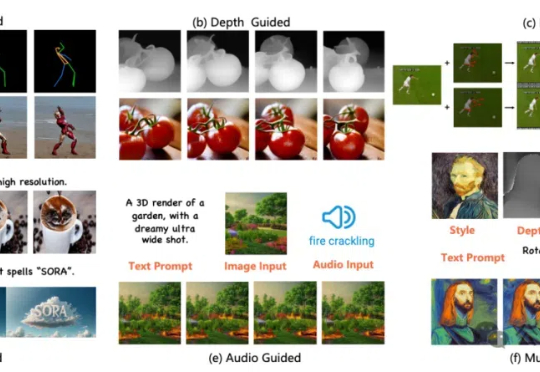
视频扩散模型新综述来了,覆盖300+文献的那种。
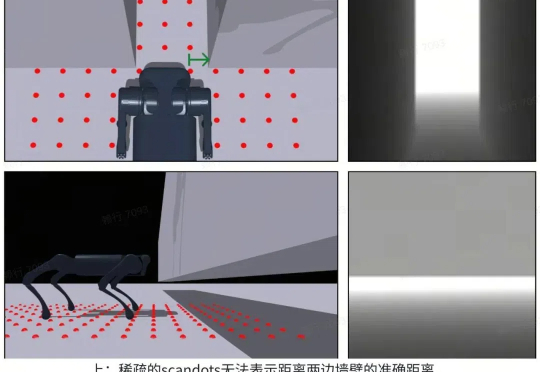
世界模型(World Model)作为近年来机器学习和强化学习的研究热点,通过建立智能体对其所处环境的一种内部表征和模拟,能够加强智能体对于世界的理解,进而更好地进行规划和决策。
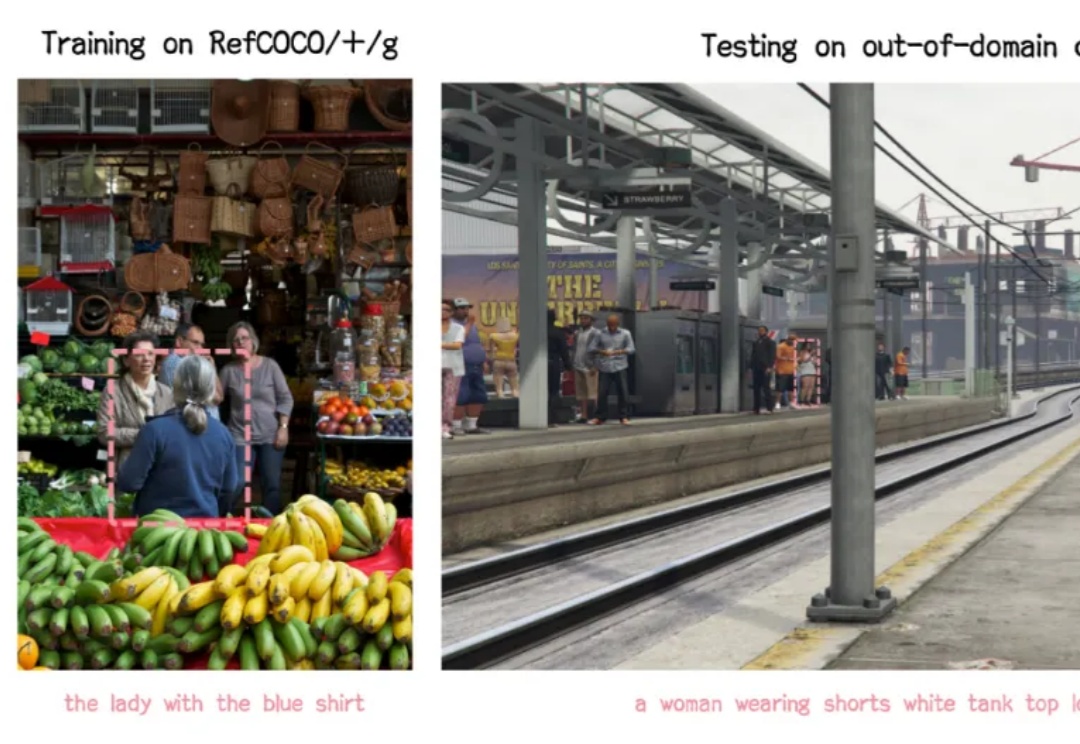
嘿,各位开发小伙伴,今天要给大家安利一个全新的开源项目 ——VLM-R1!它将 DeepSeek 的 R1 方法从纯文本领域成功迁移到了视觉语言领域,这意味着打开了对于多模态领域的想象空间!
在今年1月《Journal of Supercomputing》上开源的「开源类脑芯片」二代(Polaris 23)完整版本源代码,基于RISC-V架构,支持脉冲神经网络(SNN)和反向传播STDP。该芯片通过并行架构显著提升神经元和突触处理能力,带宽和能效大幅提升,MNIST数据集准确率达91%。
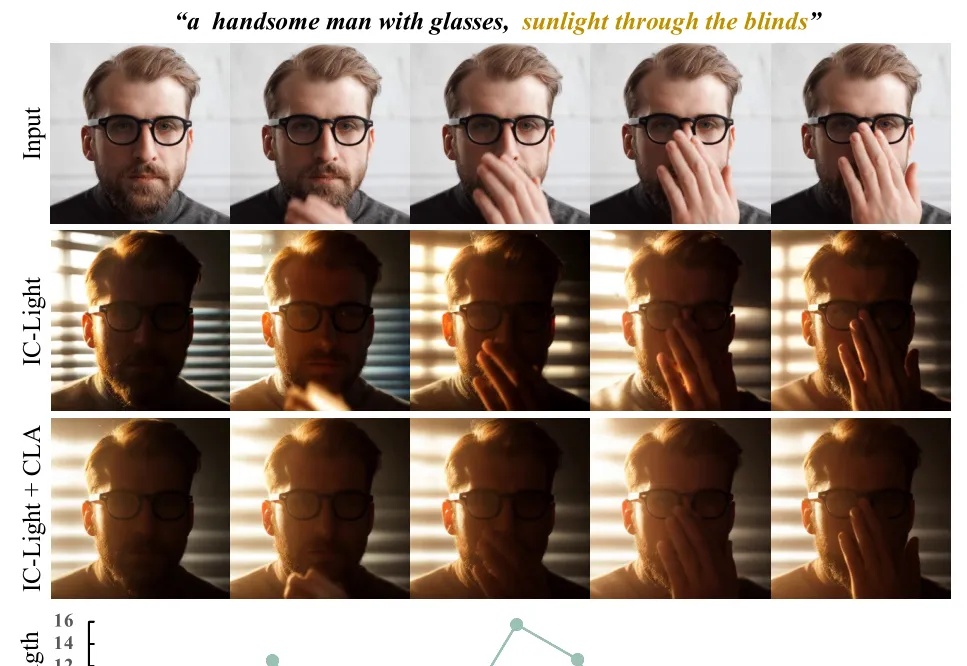
数字化时代,视频内容的创作与编辑需求日益增长。从电影制作到社交媒体,高质量的视频编辑技术成为了行业的核心竞争力之一。然而,视频重打光(video relighting)—— 即对视频中的光照条件进行调整和优化,一直是这一领域的技术瓶颈。传统的视频重打光方法面临着高昂的训练成本和数据稀缺的双重挑战,导致其难以广泛应用。
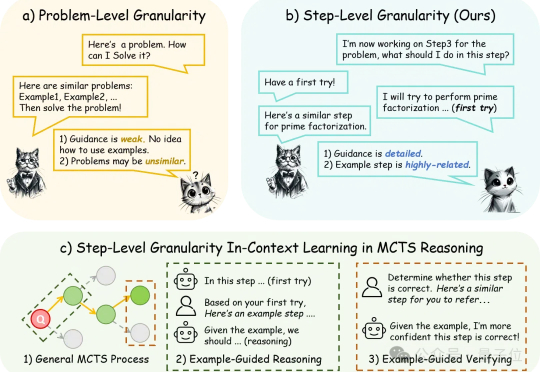
仅需简单提示,满血版DeepSeek-R1美国数学邀请赛AIME分数再提高。