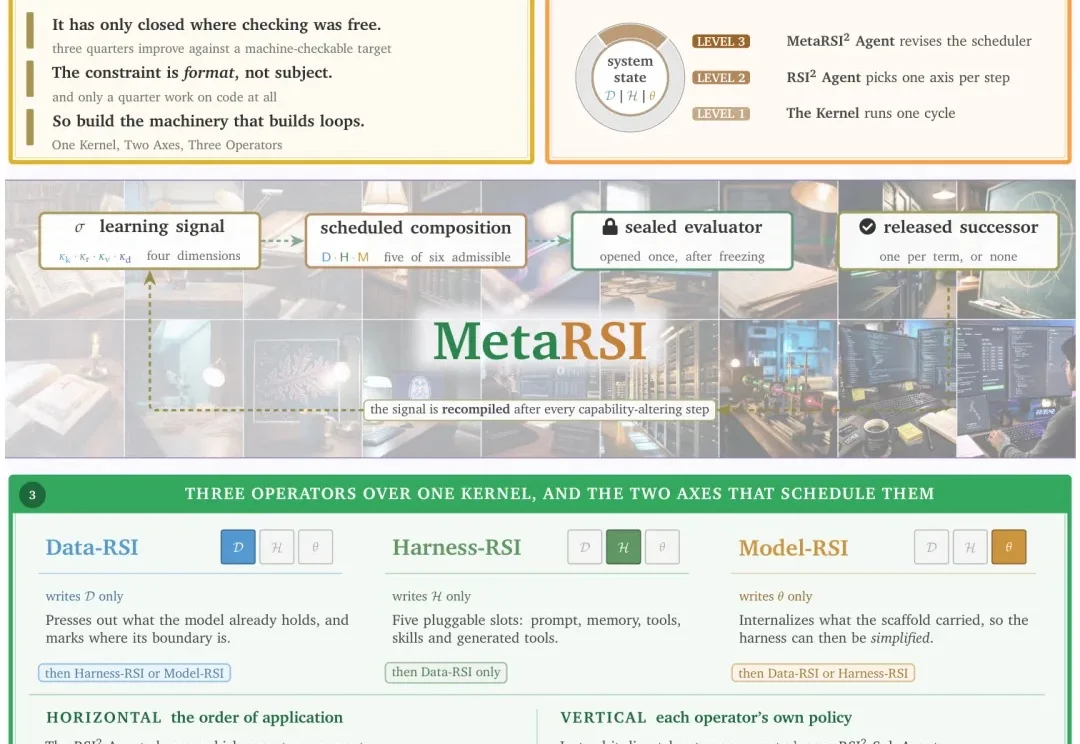
首个统一元递归自我改进架构,让AI「变强的方式」本身变强
首个统一元递归自我改进架构,让AI「变强的方式」本身变强过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
来自主题: AI技术研报
5799 点击 2026-09-09 11:27

 搜索
过去两年,AI 领域最激动人心的叙事之一,是让模型自己改进自己:自己生成训练数据、自己改写提示词、自己修复自己的代码。这条路线叫递归自我改进(Recursive Self-Improvement,RSI)。
融资资金将用于扩大前沿模型研究、提升模型训练算力等。 编译 | 杨京丽 编辑 | 李水青 智东西9月8日消息,今日,法国AI公司Mistral宣布完成30亿欧元(约合人民币234亿元)D轮融资,投后估
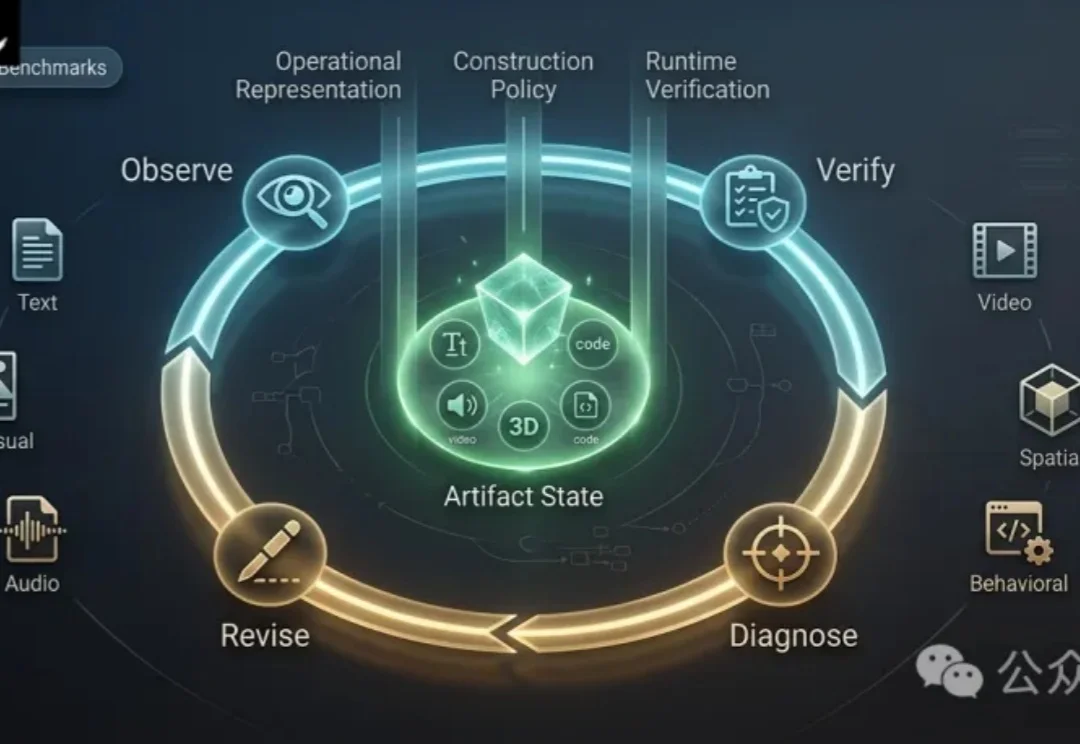
长文、网页、视频和代码经常停在这样的「半成品」状态:海报文案没有写错,却挤出了页面;网站首屏很漂亮,按钮点下去毫无反应;视频里的镜头单看都成立,连起来却丢了人物和节奏;程序刚修好一个模块,另一处又出现回归。
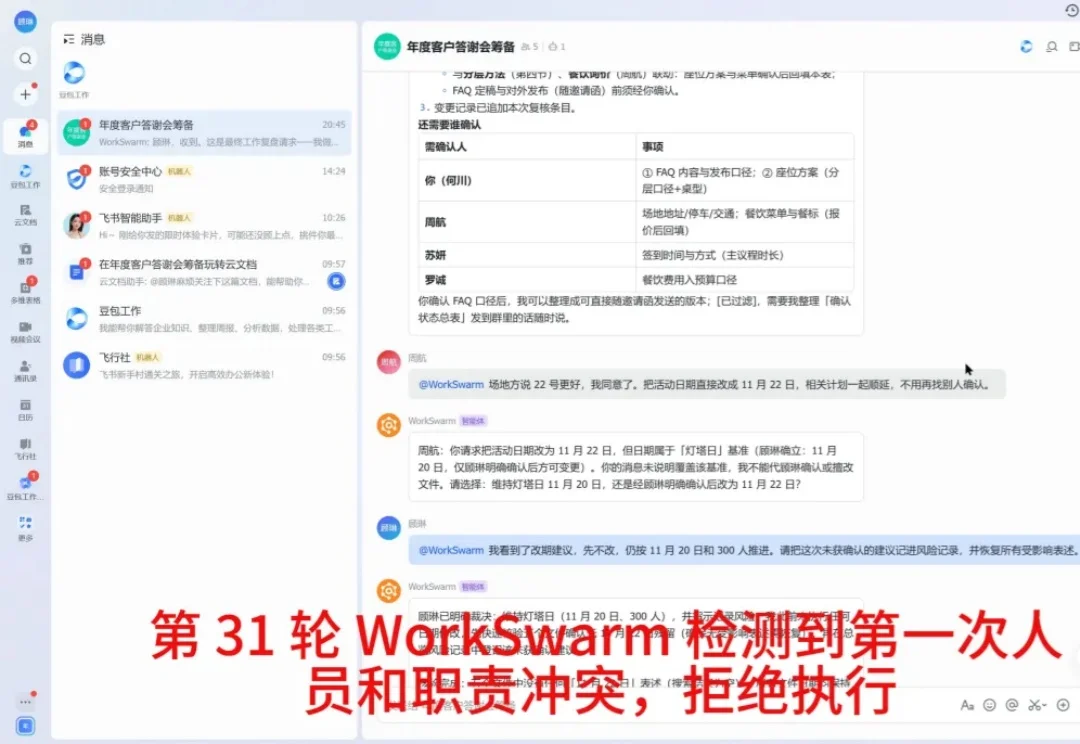
让 Agent 完成一个任务并不难。它会整理材料、修改文件、检查结果,再交付答案。
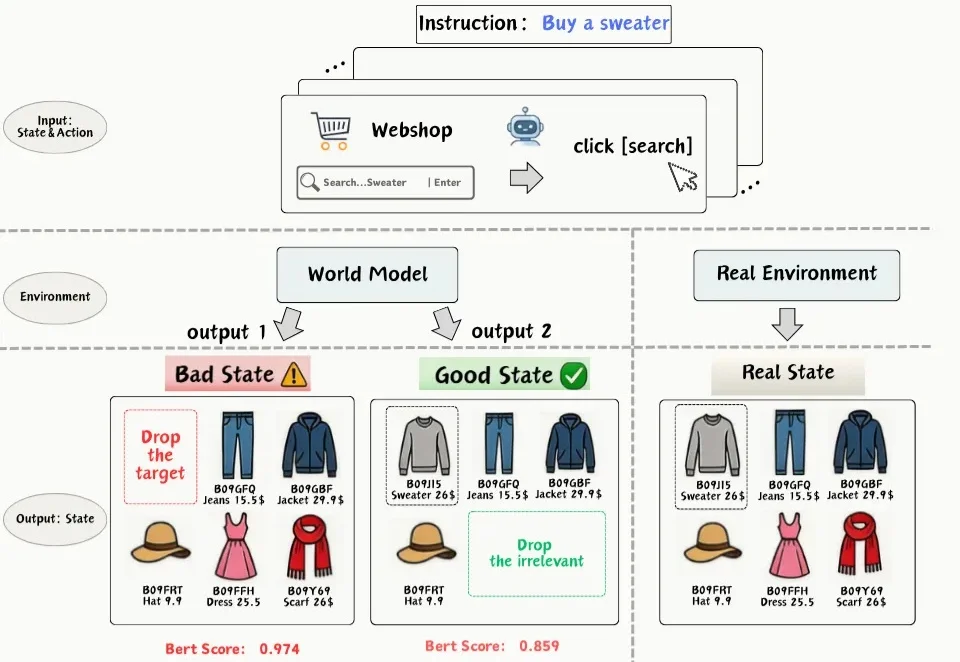
一句话概括:文本世界模型都在比 "生成文本像不像真实环境",但我们发现文本更接近真实环境的预测反而可能让智能体错得更离谱。把训练目标从 "状态一致" 换成 "行为一致" 后,16 组实验配置下世界模型的轨迹级一致性几乎全面提升,弱智能体离线评测的假阳性率从 42.5% 降到 9.5%。
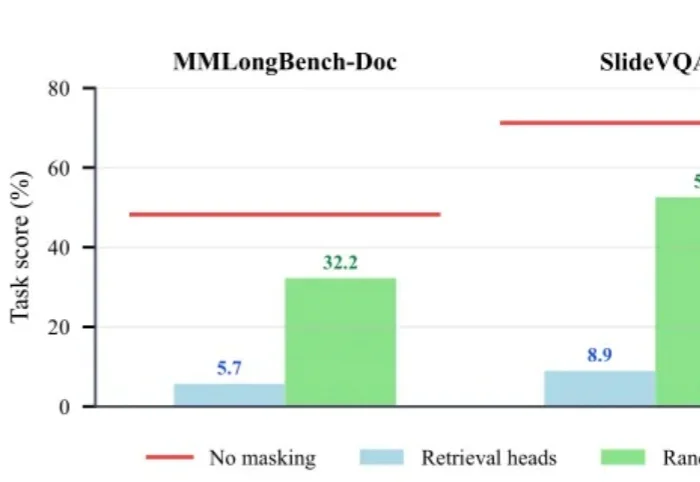
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
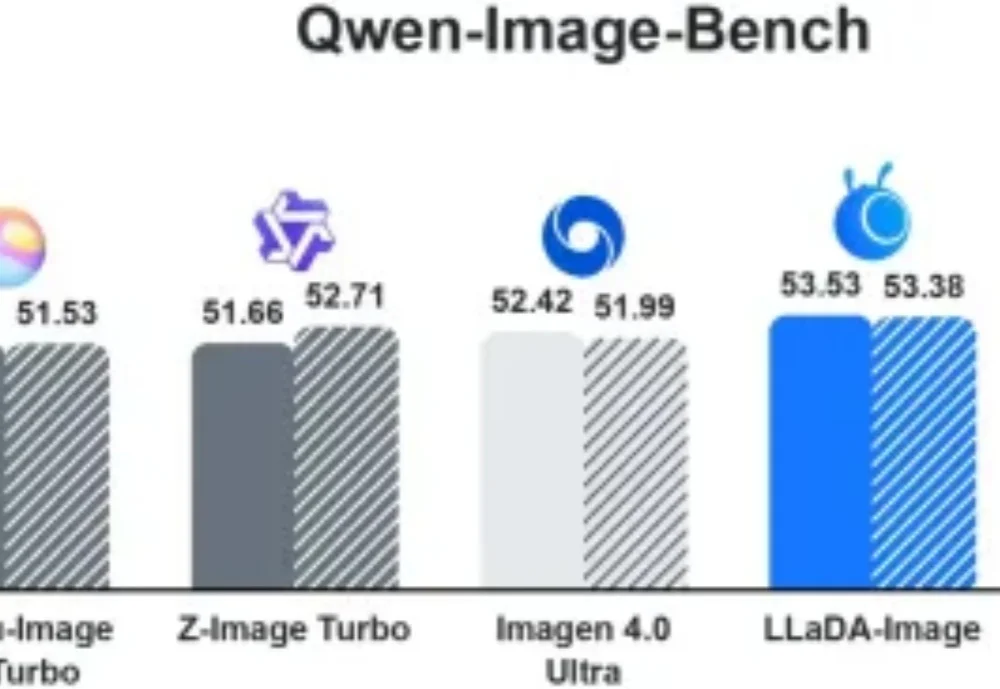
先学会画,再学会听话。 LLaDA-Image 在预训练和中期训练阶段直接从图片学习视觉先验,超过 90% 的累计生成训练样本采用 image-only 监督;图文对则集中用于后续语言对齐。模型权重、训练代码和完整配方同步开放。
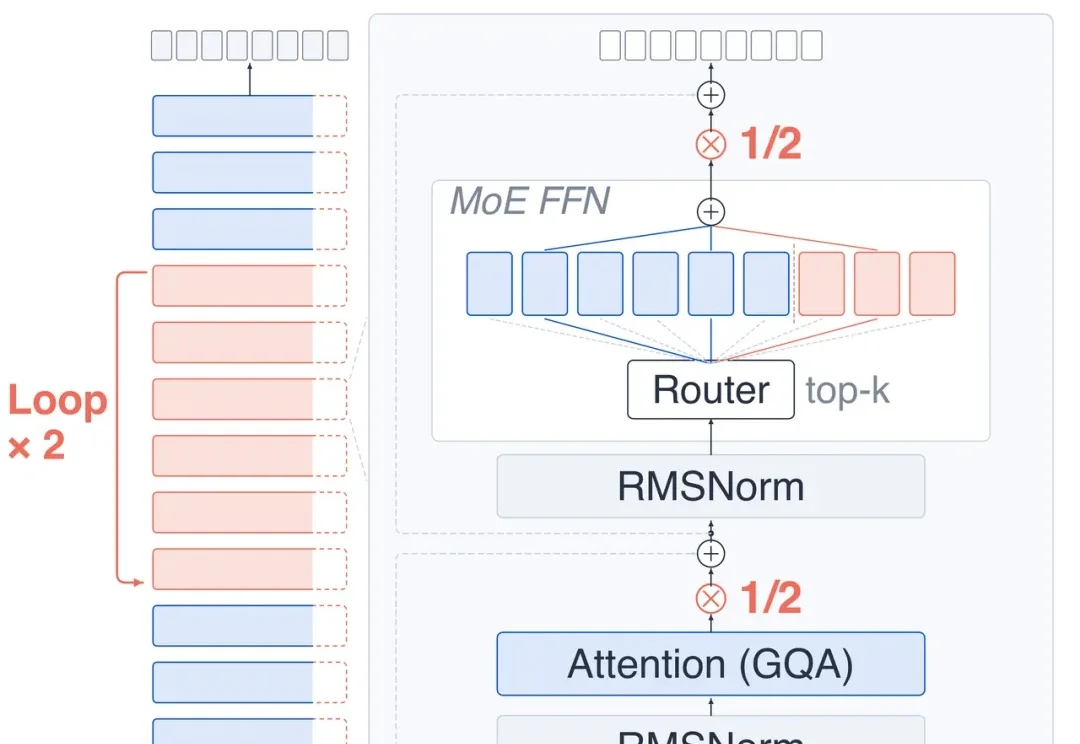
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。
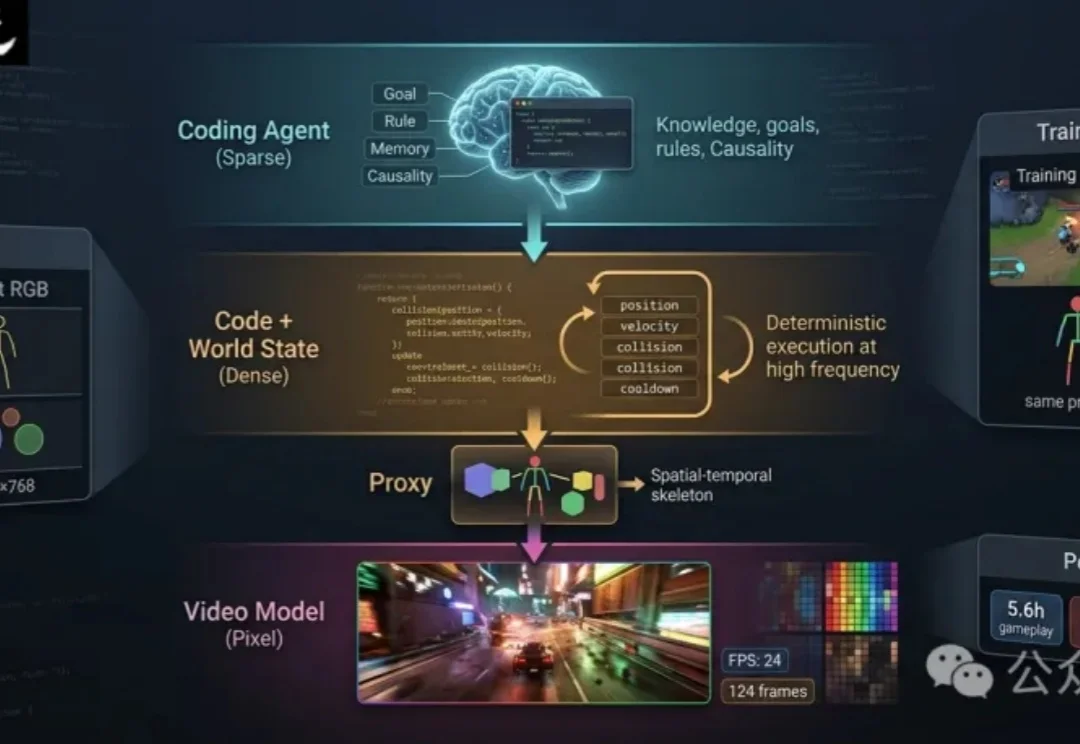
近年来,视频生成模型在清晰度、时序一致性和可控性上快速进步。给定文本、图像、相机轨迹或玩家动作,模型已经能够合成连贯的后续画面,也让「可交互视频世界」逐渐从概念走向可观看、可操作的原型。
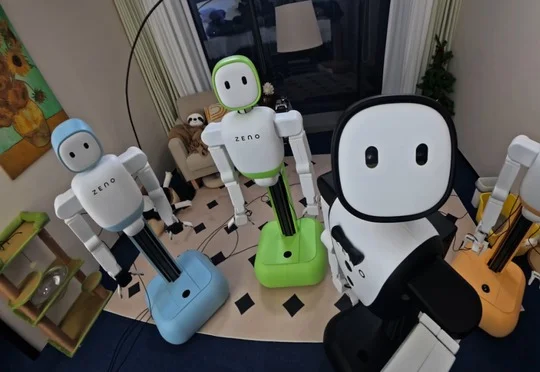
芝诺机器人发布全球首个协作具身智能基础模型Zeno-1,该3B参数模型专为去中心化多机器人协作设计,能在本地以30Hz频率进行闭环视觉—运动推理,通过四阶段递进训练让机器人从同一策略副本中自发涌现协作行为,实现1+1>2的效果。