北大发布ConsisID:无需训练Lora,就可以定制化个人视频写真!
北大发布ConsisID:无需训练Lora,就可以定制化个人视频写真!这两天,北京大学等研究团队发布了一个视频生成的可控生成工作:ConsisID。ConsisID可以实现无需训练Lora的保持参考人脸一致性的文生视频,类似之前图像生成的IP-Adapter-Face和InstantID等工作。虽然之前也有类似的工作,但是ConsisID在效果更上一个台阶。
搜索
这两天,北京大学等研究团队发布了一个视频生成的可控生成工作:ConsisID。ConsisID可以实现无需训练Lora的保持参考人脸一致性的文生视频,类似之前图像生成的IP-Adapter-Face和InstantID等工作。虽然之前也有类似的工作,但是ConsisID在效果更上一个台阶。
在当今的人工智能领域,Transformer 模型已成为解决诸多自然语言处理任务的核心。然而,Transformer 模型在处理长文本时常常遇到性能瓶颈。传统的位置编码方法,如绝对位置编码(APE)和相对位置编码(RPE),虽然在许多任务中表现良好,但其固定性限制了其在处理超长文本时的适应性和灵活性。
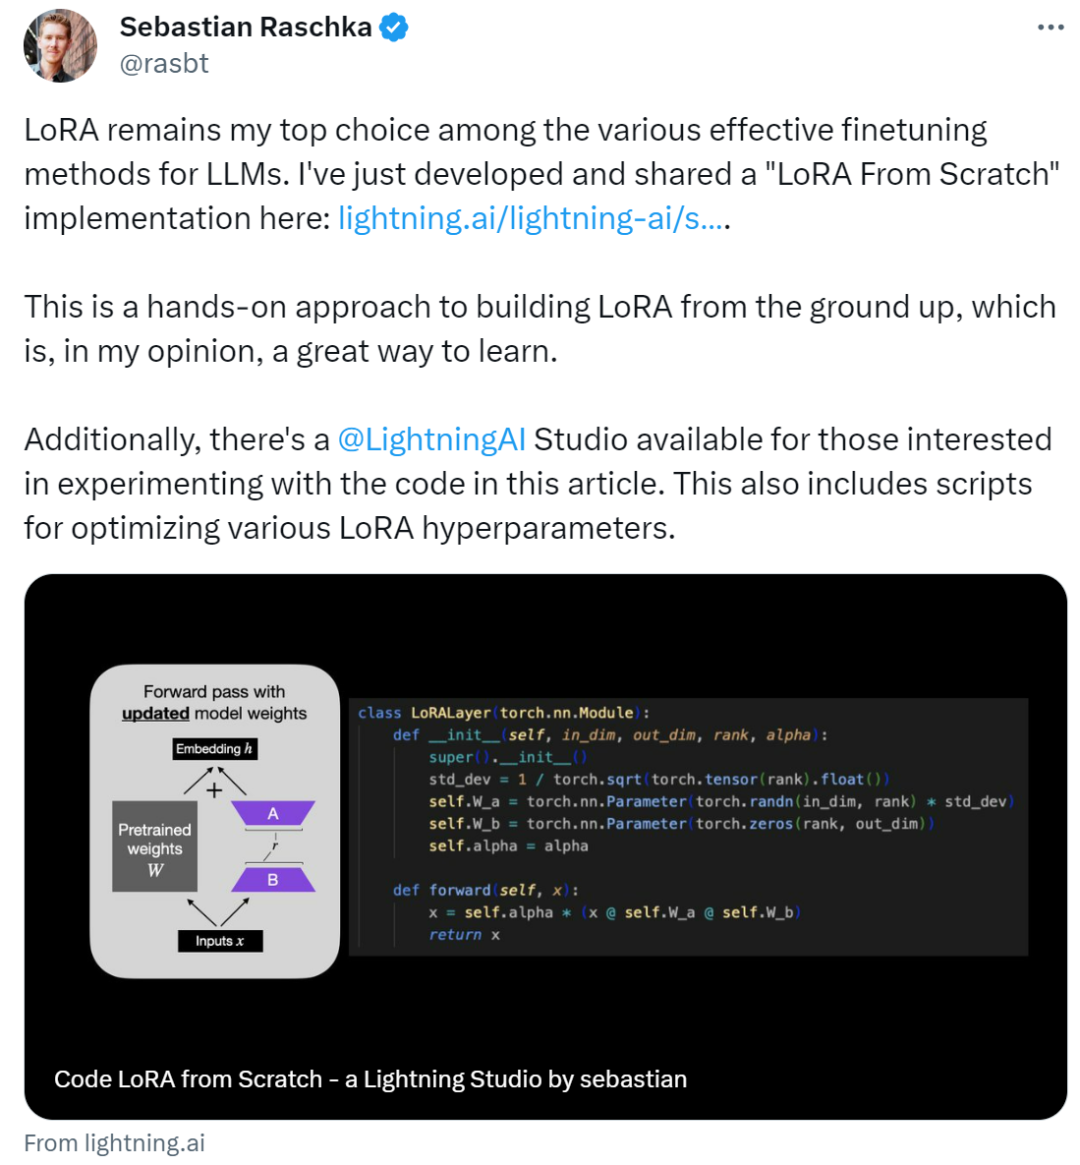
低秩适应(Low-Rank Adaptation,LoRA)通过可插拔的低秩矩阵更新密集神经网络层,是当前参数高效微调范式中表现最佳的方法之一。此外,它在跨任务泛化和隐私保护方面具有显著优势。
作者表示:在各种有效的 LLM 微调方法中,LoRA 仍然是他的首选。LoRA(Low-Rank Adaptation)作为一种用于微调 LLM(大语言模型)的流行技术,最初由来自微软的研究人员在论文《 LORA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS 》中提出。
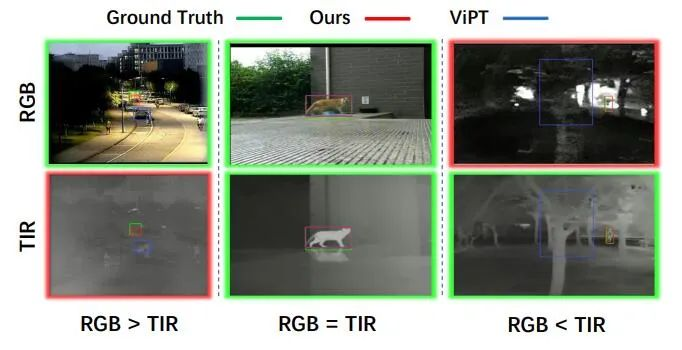
目标跟踪是计算机视觉的一项基础视觉任务,由于计算机视觉的快速发展,单模态 (RGB) 目标跟踪近年来取得了重大进展。考虑到单一成像传感器的局限性,我们需要引入多模态图像 (RGB、红外等) 来弥补这一缺陷,以实现复杂环境下全天候目标跟踪。
图像到视频生成(I2V)任务旨在将静态图像转化为动态视频,这是计算机视觉领域的一大挑战。其难点在于从单张图像中提取并生成时间维度的动态信息,同时确保图像内容的真实性和视觉上的连贯性。大多数现有的 I2V 方法依赖于复杂的模型架构和大量的训练数据来实现这一目标。
参数高效的微调方法SUR-adapter,可以增强text-to-image扩散模型理解关键词的能力。