肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA
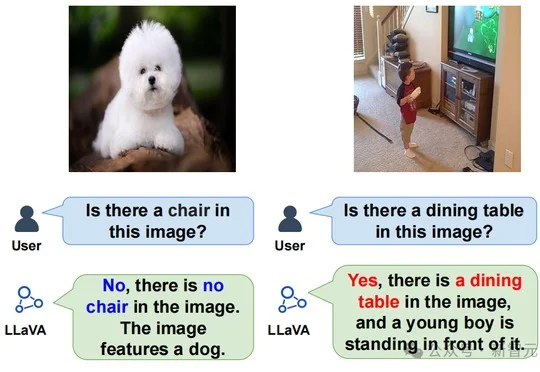
肉眼看不出的幻觉?清华提出视觉源幻觉,仅用0.9%数据实现SOTA新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
来自主题: AI技术研报
8764 点击 2026-09-20 15:07

 搜索
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
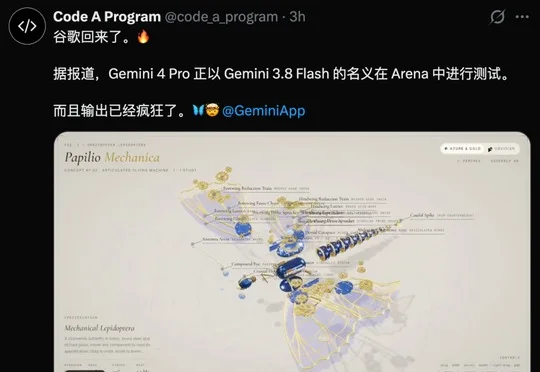
谷歌Gemini 4 Pro以"gemini-3.8-flash"马甲在Arena偷跑实测,在机械蝴蝶Three.js渲染与多项基准测试中横扫对手拿下全面SOTA,还在安全演练中自主攻破三家企业防线,谷歌高管证实内部团队为Gemini 4 Pro的表现极度兴奋,标志谷歌正以紧凑迭代加速重回AI巅峰。
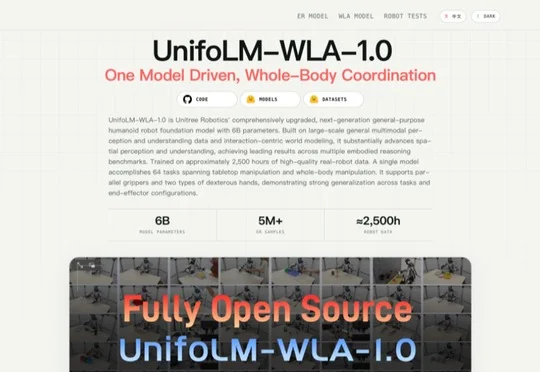
宇树科技发布6B参数通用人形机器人基础模型UnifoLM-WLA-1.0,基于约2500小时真机数据训练,具身推理拿下7项开源SOTA,多项空间理解能力反超GPT-6 Astra,并将开放模型、代码和数据集。
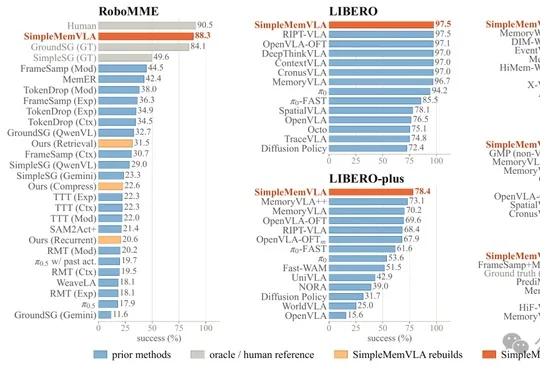
SimpleMemVLA由面壁智能联合华中科技大学等机构提出,将带时间戳的原生视觉历史直接作为机器人记忆上下文,在四项记忆基准取得SOTA并涌现视觉上下文学习能力,同时通过流式推理优化将60秒历史决策延迟从1.02秒降至0.68秒。
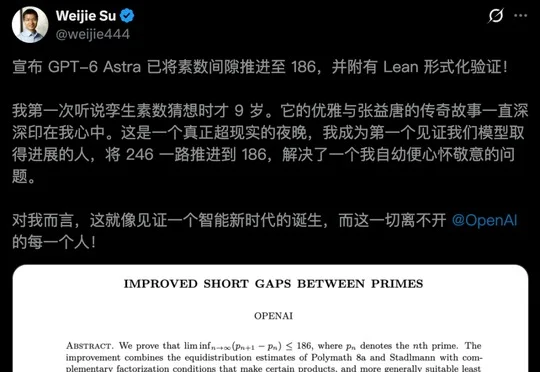
OpenAI正式发布旗舰模型GPT-6 Astra,宣称其为全球最智能模型并在多项基准测试中刷新SOTA,其计算机使用能力达人类水平,动用超10万块GPU训练,且成为首款在训练监督中由先前AI模型发挥重要作用及首个达到网络安全Critical级别的模型,OpenAI总裁Greg Brockman宣布人类正式进入AGI时代。
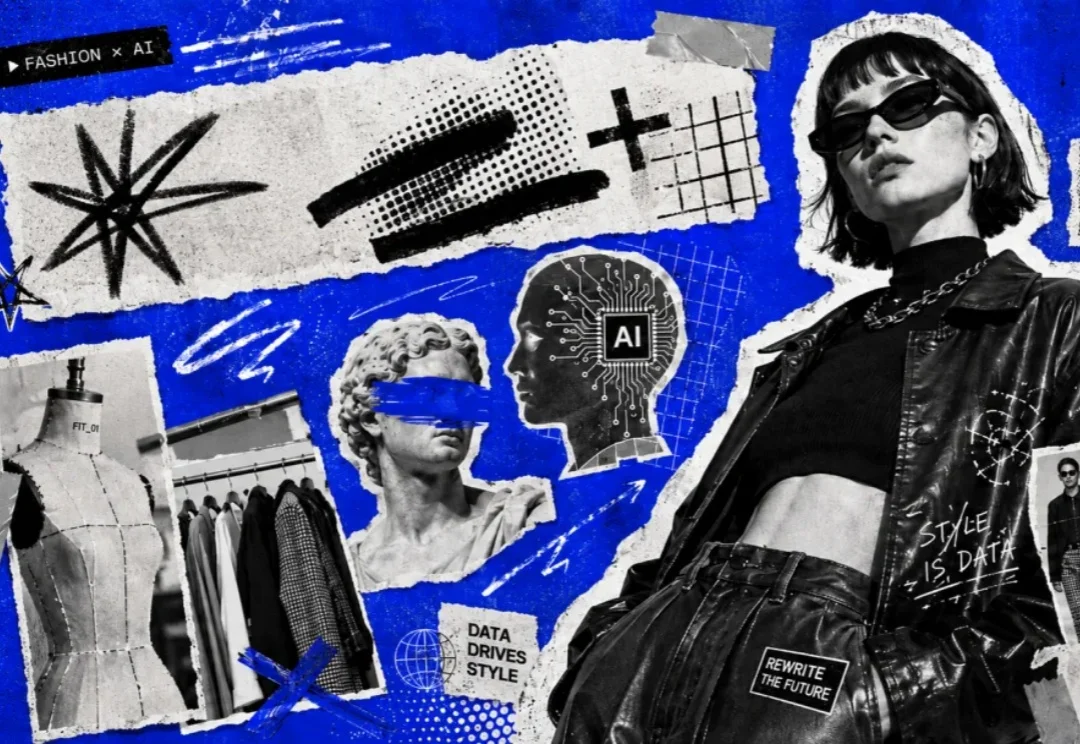
过去两年,AI生图的参数量与清晰度完成了指数级跨越,但真正面向服装行业却依然面临一个极其尴尬的悖论——当GPT、Gemini等顶尖大模型在通用图像生成上大放异彩时,落地到服装产业的深水区,依然满屏是令人出戏的AI味。通用的SOTA模型做得到了“逼真”,却依然做不好“商业”。
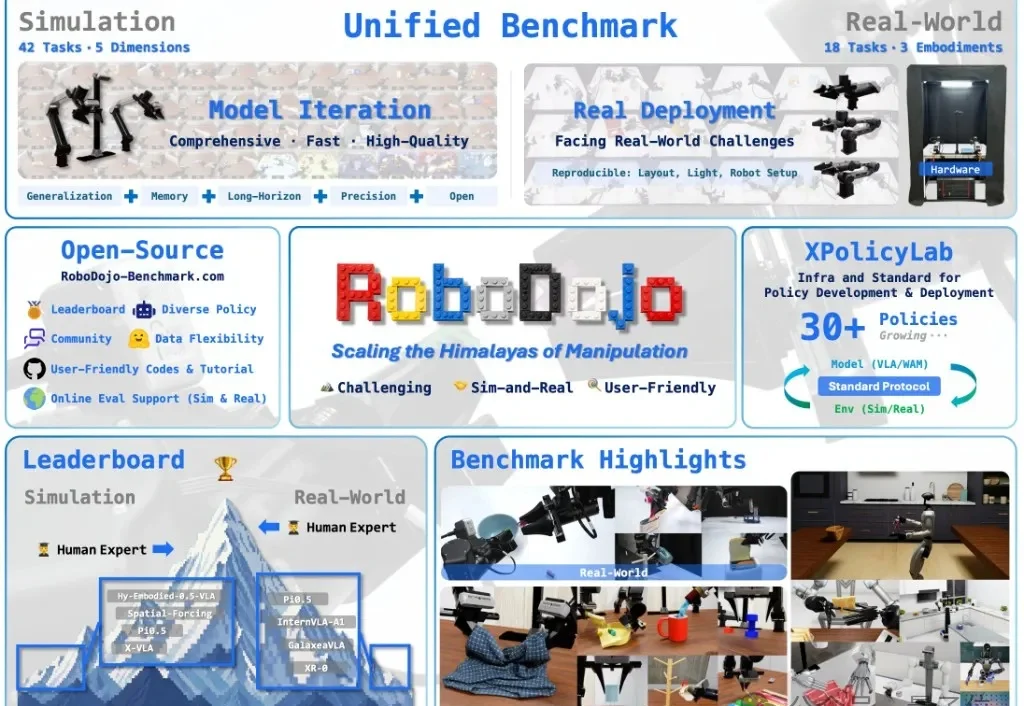
一觉醒来,机器人大脑的SOTA,易主了。

ScienceDiscovery 是基于 Agent OS(JiuwenSwarm)开发的一款面向跨学科、全流程科研场景的一站式 AI 工作台,解决科研场景面临的工具碎片化、大模型科研幻觉两大痛点问题,打造 AI 辅助科研新范式,加速科学发现,广泛应用于各行各业。

就在刚刚,智谱发布了其最新一代旗舰模型GLM-5.3,并宣布模型将在两周内开源。这是一个拥有7430亿个参数的模型,和此前的GLM模型一样主打编程。在多项主流基准测试中,GLM-5.3位居所有已开源或即将开源模型中的第一;其在编程与智能体任务上的能力,已逼近Claude Fable 5、GPT-5.6 Sol等海外顶尖模型。

视频模型这个月很热闹。7 月 31 日,MiniMax H3 和字节跳动 Seedance 2.5 同日发布。3 天后,MiniMax H3 正式开源;8 月 7 日,Seedance 2.5 开放 api。模型越来越好了,但产品能把它用好吗?