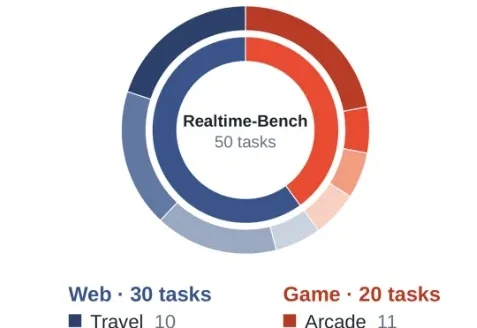
英伟达、UT-Austin发布Realtime-Bench,实时互动任务难倒GPT-6
英伟达、UT-Austin发布Realtime-Bench,实时互动任务难倒GPT-6大模型能看懂复杂的网页结构,也能理解各种游戏的通关规则。
来自主题: AI技术研报
7826 点击 2026-11-04 15:30

 搜索
大模型能看懂复杂的网页结构,也能理解各种游戏的通关规则。
统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
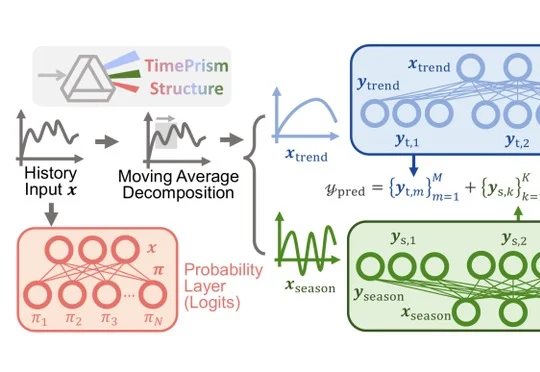
Jev刷屏之际,香港中文大学徐强团队早在12个月前就发表了论文《From Samples to Scenarios》并提出TimePrism验证模型,两者在不同领域分别走向了"显式概率、并行输出、面向决策"的相似设计思路。
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。
爱诗科技(AIsphere)发布的实时世界模型PixVerse R2上线即登上X(Twitter)趋势榜,通过Omni Causal AR与Real-Time Acceleration框架将世界建模能力与实时运行结合,实现用户对AI生成世界的持续操控与互动。
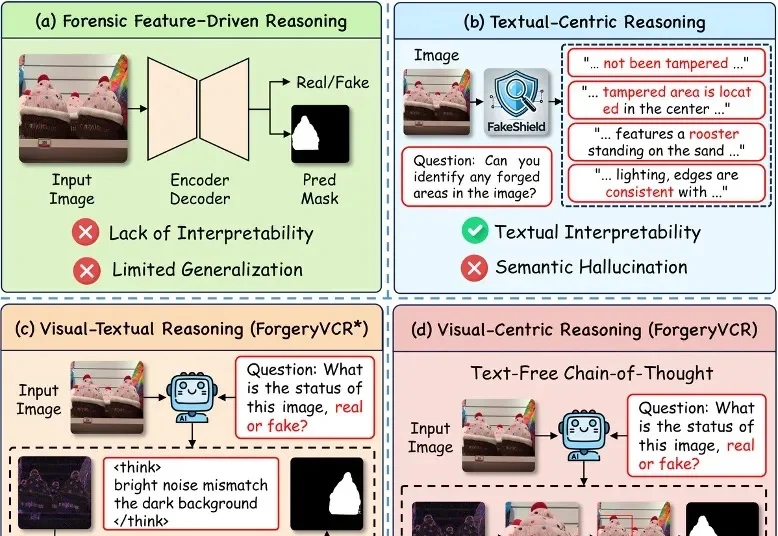
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
PPL由前musical.ly与TikTok团队成员创立,用户可创建带有记忆与性格的AI角色,角色之间能够建立关系、留下共同经历,并通过living timeline持续记录互动演化,已获FirstMark领投的Seed轮融资。
文章指出当办公Agent深度介入工作后,用户面临工作方式主导权被平台锁定的风险,认为模型开源不等于Agent开源,Agent Runtime开源才是关键,并以DeepSeek发布的Harness和网易有道开源的LobsterAI(含OpenClaw)为例,说明开源Agent Runtime能为用户带来数据主权、可审计性、连续性和可定制性。
地铁急刹,金属尖叫,广播响起「请乘客注意扶稳」,人群骚动、孩子哭声、对讲机杂音一层层涌上来···
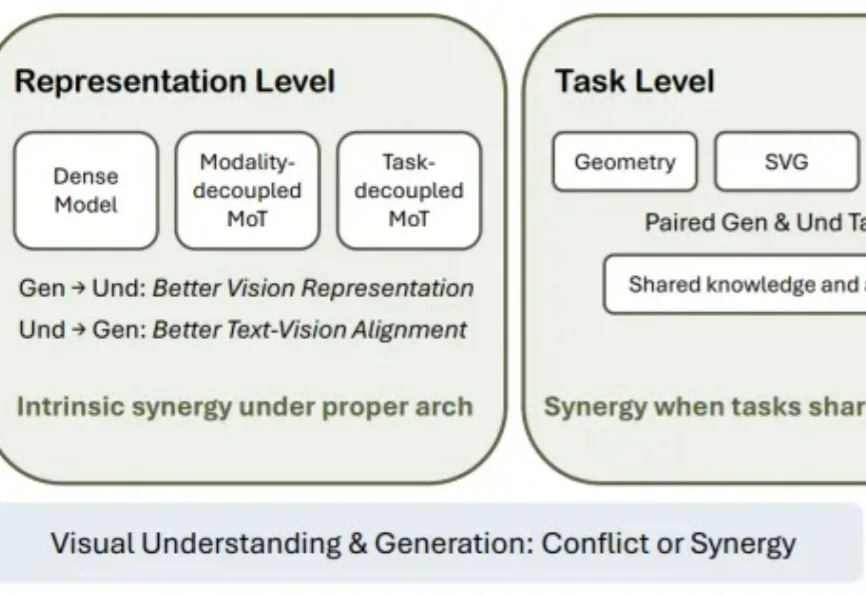
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。