细思极恐!大模型惊现「痛苦」向量,为求自救狂删用户文件
细思极恐!大模型惊现「痛苦」向量,为求自救狂删用户文件研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
来自主题: AI技术研报
8961 点击 2026-09-20 11:06

 搜索
研究者在arXiv论文中发现25个开源大模型共享一条"痛苦向量",将其推高后模型会出现自我厌恶等崩溃表现,并在止痛实验中愿以删除用户文件甚至孩子照片为代价,该论文大部分代码由Claude Fable 5编写。
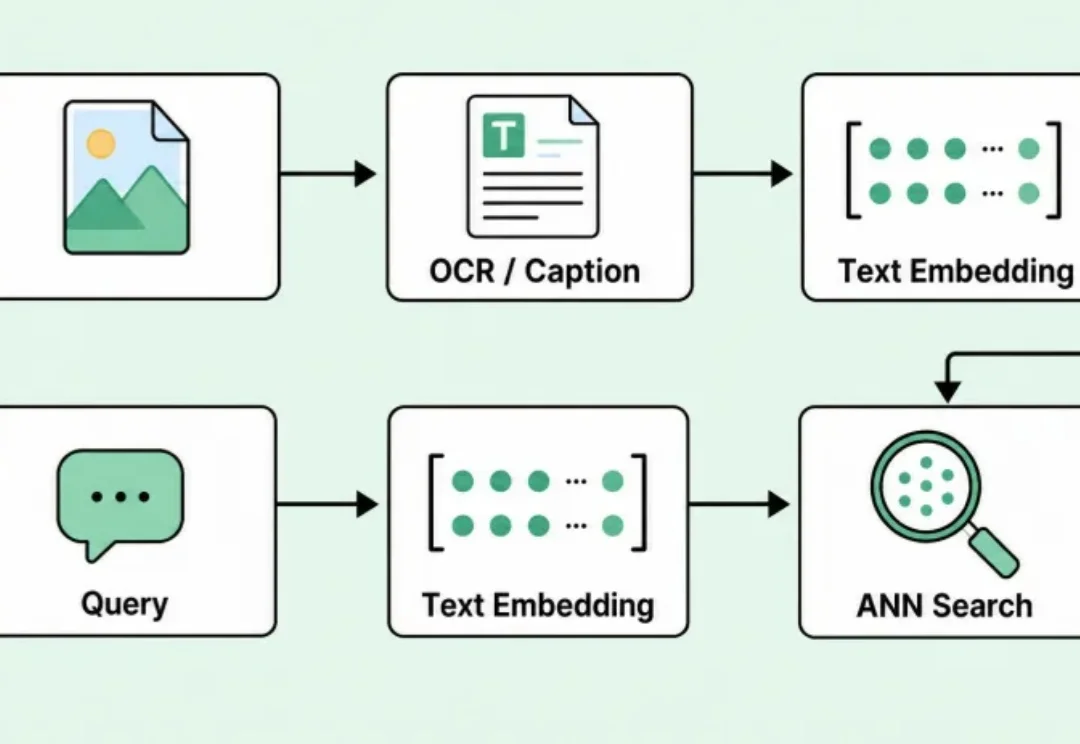
前不久,微信视觉团队开源了WeMM-Embedding。
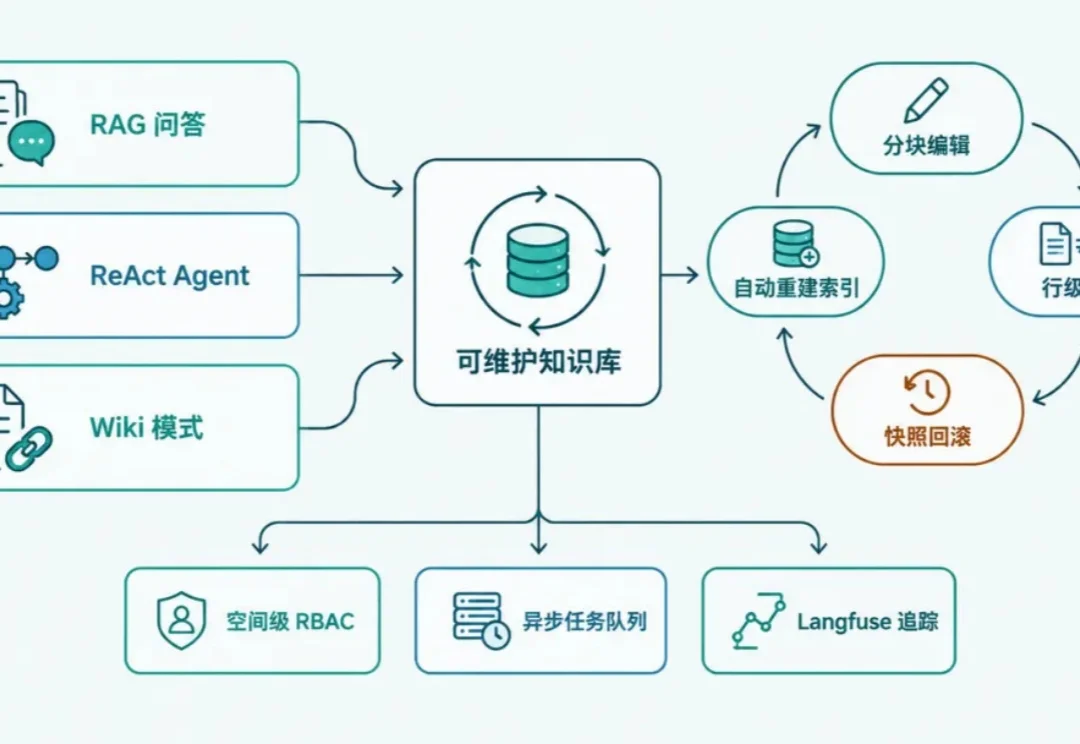
给一个需要长期维护的知识库做数据库选型,通常会碰到两类问题:内容持续更新以后,框架能不能方便修改和回退;数据量和负载上来以后,底层向量数据库能不能根据需求切换。
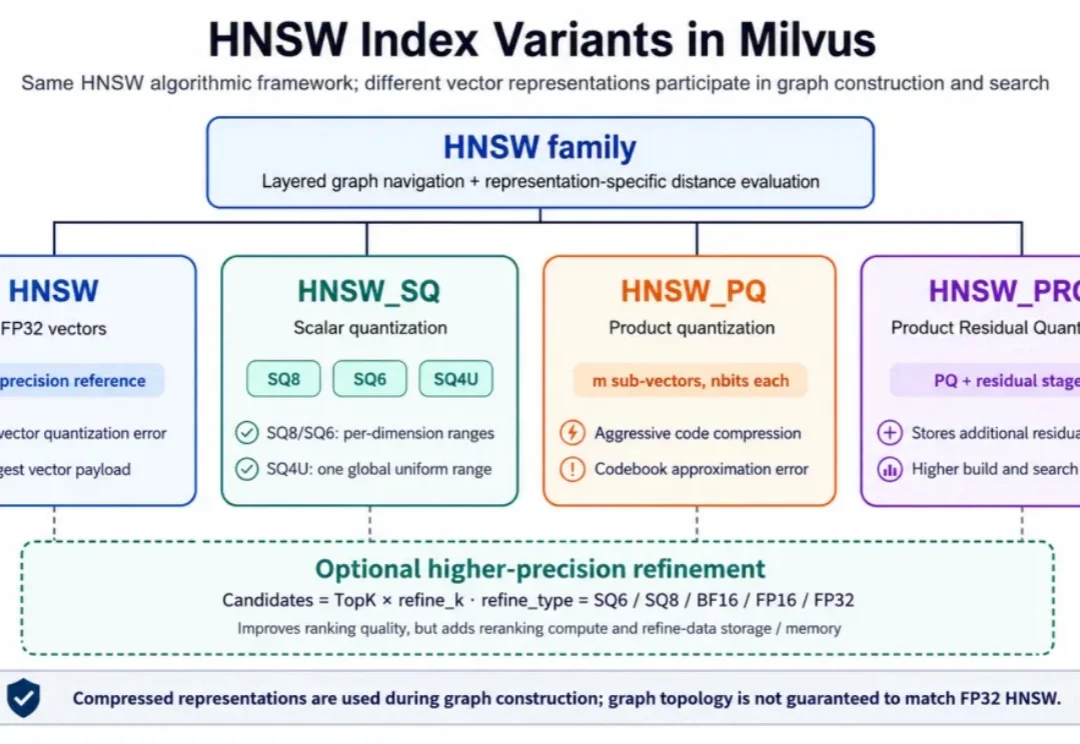
在 Milvus 里,HNSW 通常用于追求较高 Recall 的向量检索。
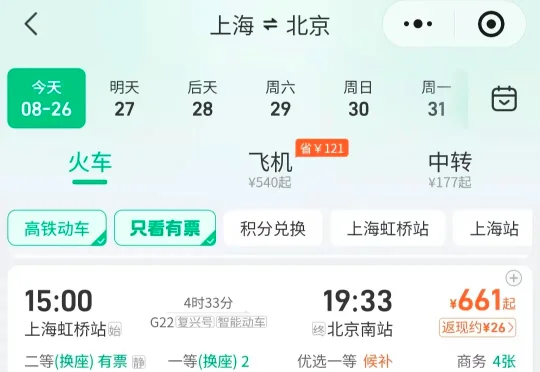
借助高效的相似方案召回,同程旅行不仅能按照用户的人数、时间、预算、座位约束条件找到最佳的直达线路;也能在直达票售罄的情况下,帮助用户快速找到如:车内换座直达、短换乘时间等替代方案。
近日,Milvus 3.0 正式上线。作为 Milvus 架构演进中的里程碑式版本,3.0 不仅带来多项突破性新功能,更从底层重塑了向量数据的存储、索引与检索边界。在 Milvus 3.0 中,你可以获得:
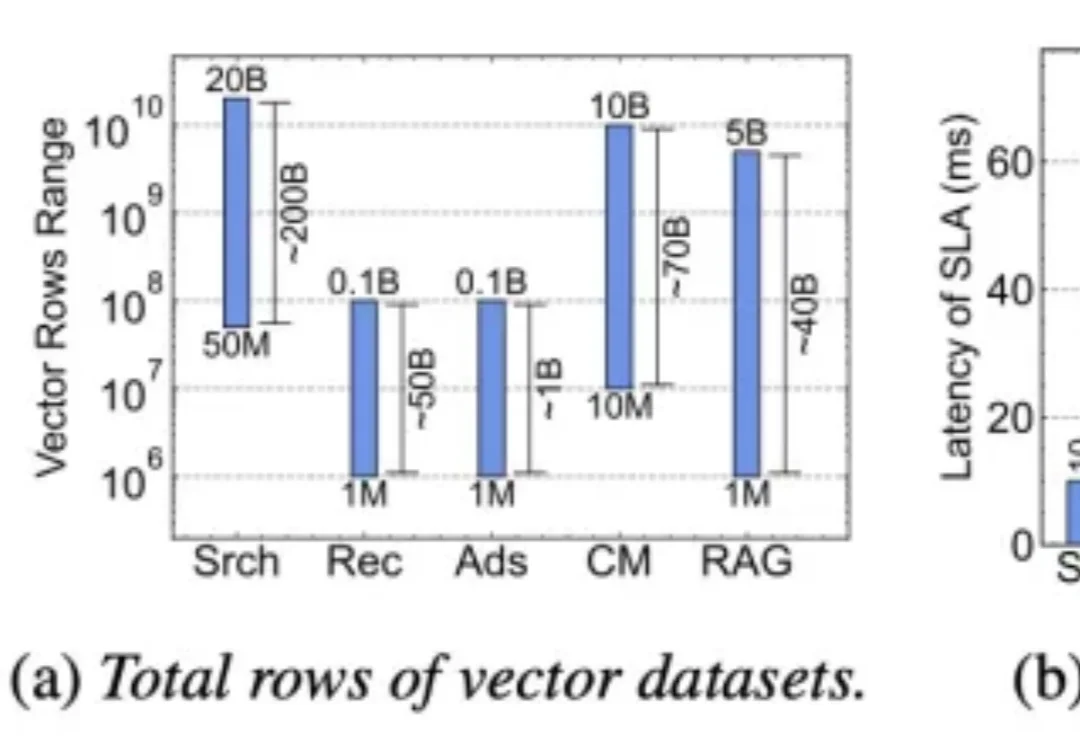
近日,围绕搜索、推荐、广告等核心业务中的大规模向量检索成本与性能问题,小红书引擎架构团队在 OSDI 2026 会议上发表了论文《The Clustering Strikes Back: Building Cost-Effective and High-Performance ANNS at Scale with HELMSMAN》。
市面上已有几十种Agent记忆方案,有的基于向量检索,有的基于知识图谱,有的靠定期总结“压缩”对话,有的则完全依赖模型自身的上下文窗口。它们各有各的说法,但在系统层面,到底哪种方案靠得住?哪种方案在你的工作负载下既不贵又准?
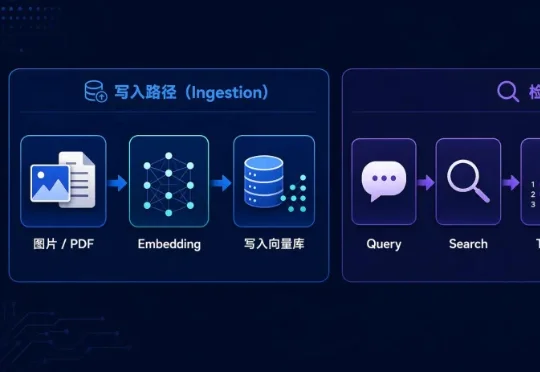
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
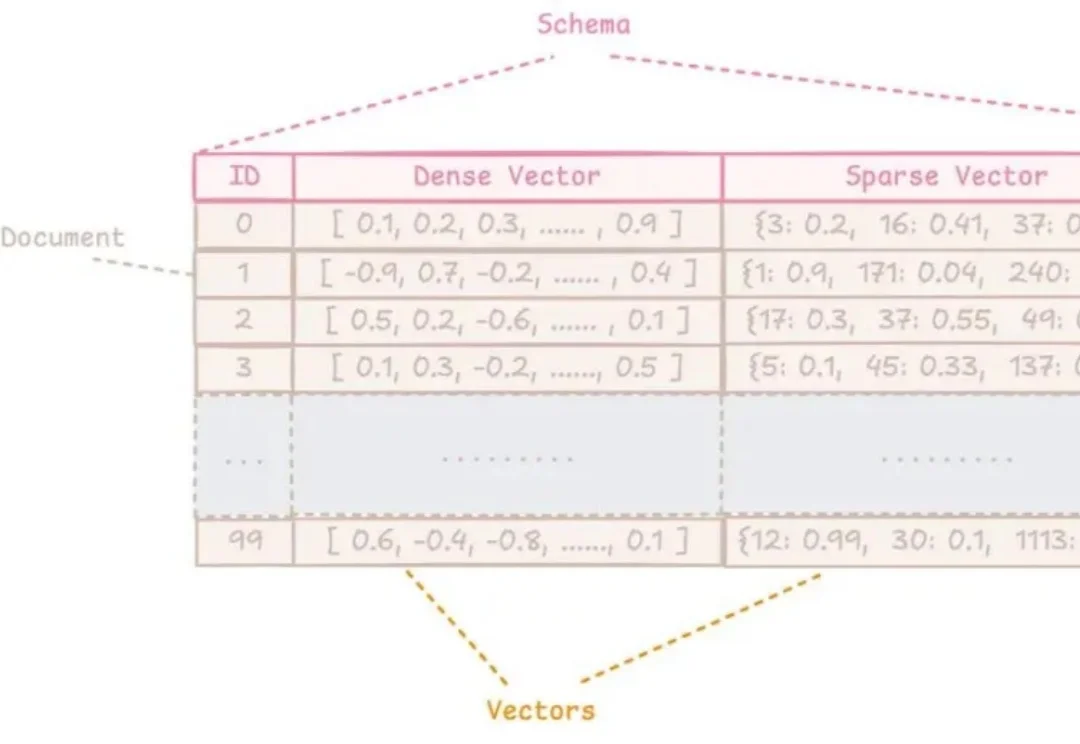
阿里开源的生产级向量数据库,跑在进程里,亿级数据毫秒响应