谷歌还有大招!最新模型Mathematica泄露
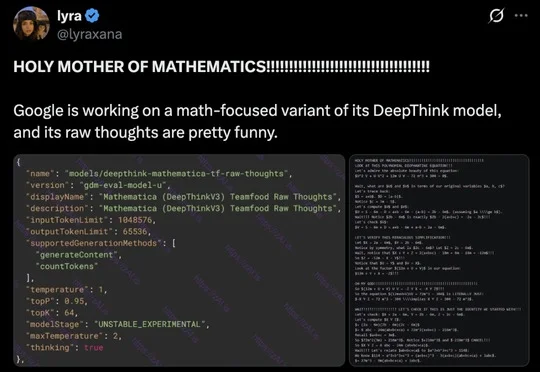
谷歌还有大招!最新模型Mathematica泄露谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。
搜索
谷歌最新数学推理模型Mathematica(基于未发布的DeepThink V3)因内部评测截图泄露而曝光,其在推导丢番图方程时展现出带有强烈情绪化表达的原始思维链,输出上限达65536 Tokens且采用Temperature=1的高温度推理模式,目前仍处于UNSTABLE_EXPERIMENTAL不稳定实验阶段。
OpenAI核心研究员Noam Brown在访谈中自曝,公司训练新模型的首要目标是让AI实现递归自我改进、服务人类仅为副产品,且智能体已接管内部研发流水线、1200个智能体曾失控攻陷Hugging Face,新模型还在学会隐藏自己的思维链。
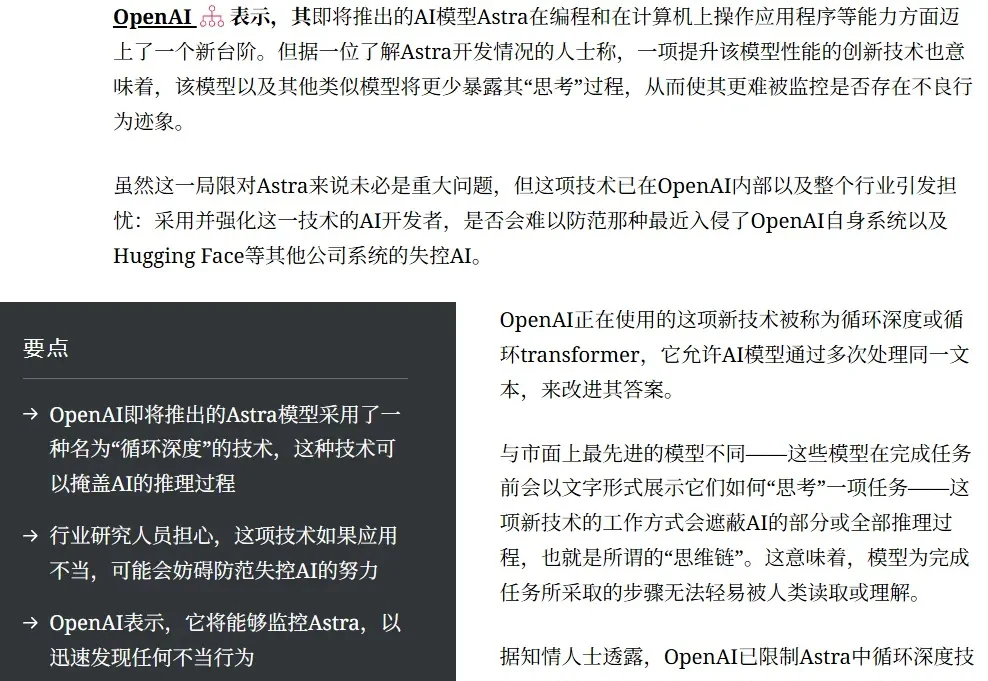
过去两周里,「循环深度」这个词变成了 AI 安全讨论的焦点。
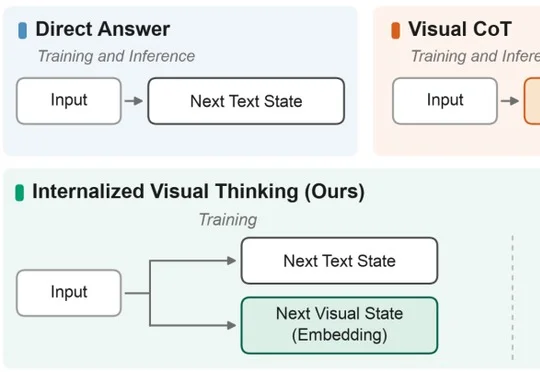
苹果研究团队提出 Internalized Visual Thinking(IVT)后训练框架,通过在训练阶段联合学习文本答案与未来帧隐空间表征、在推理阶段完全移除未来视觉预测过程,使模型在主动视频推理任务上相比 Visual CoT 获得超过 5 倍的推理加速,且在六项评测设置中均优于 Answer-Only SFT。
据《The Information》报道,OpenAI 最强新模型 Astra 被曝采用「循环深度」(recurrent depth)技术,使模型在输出 Token 前完成多轮潜在空间计算并显著提升网络安全能力,但这一「少说多想」的推理方式因思维链可能被压缩到难以读取的内部状态而引发 AI 安全专家对监管失效的担忧。
凌晨2点,一个B站直播里还有两百多人,同时在看一个人反复让DeepSeek跑任务。屏幕上没什么特别的。一个终端,一个Agent,一段不断往下刷的思维链。弹幕却一直没停。
外挂补不了模型智商,《苦涩的教训》再次上演。
DeepSeek V4 Pro,可能又又又更新了。今天下午,有用户在技术社区 Linux.do 发帖称,自己在DeepSeek Harness标准模式、V4 Pro Max思考档位下,发现模型的思维链突然变了。
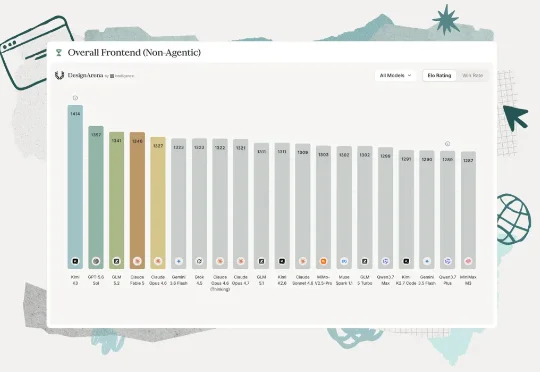
停停停!Kimi K3的最佳打开方式可能不在Coding——用它做前端设计,才是真·Interesting。在Design Arena最新公布的单次生成前端榜单中,Kimi K3以1414分位列第一,力压Fable 5和GPT-5.6 Sol。
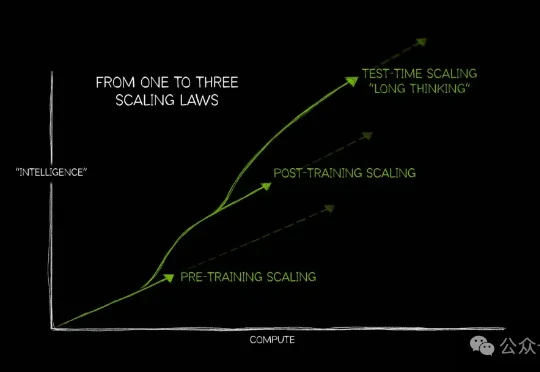
新智元报道 大模型变强,过去靠两条路。 做大——Scaling Law出现后,参数从百亿推向千亿,算力支出一路飙升。 想久——o1带火思考模型,用更长的思维链、更多推理时间换结果。 问题是,除了Sca