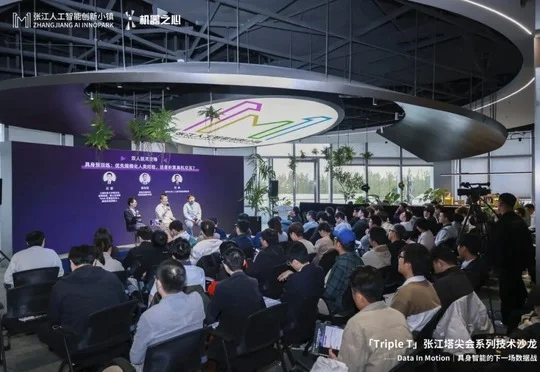
百万小时数据喂下去,机器人就能学会一切?这场塔尖会拆解「具身数据战」
百万小时数据喂下去,机器人就能学会一切?这场塔尖会拆解「具身数据战」Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
来自主题: AI资讯
7896 点击 2026-11-06 10:34

 搜索
Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
成都中和与天津侯台都是城郊结合处的老村镇。一群人在这里为大型互联网公司训练大模型,大多月薪不足 1 万元。
OpenAI 最近公布了一组 ChatGPT 的新数据,有几个变化挺有意思:
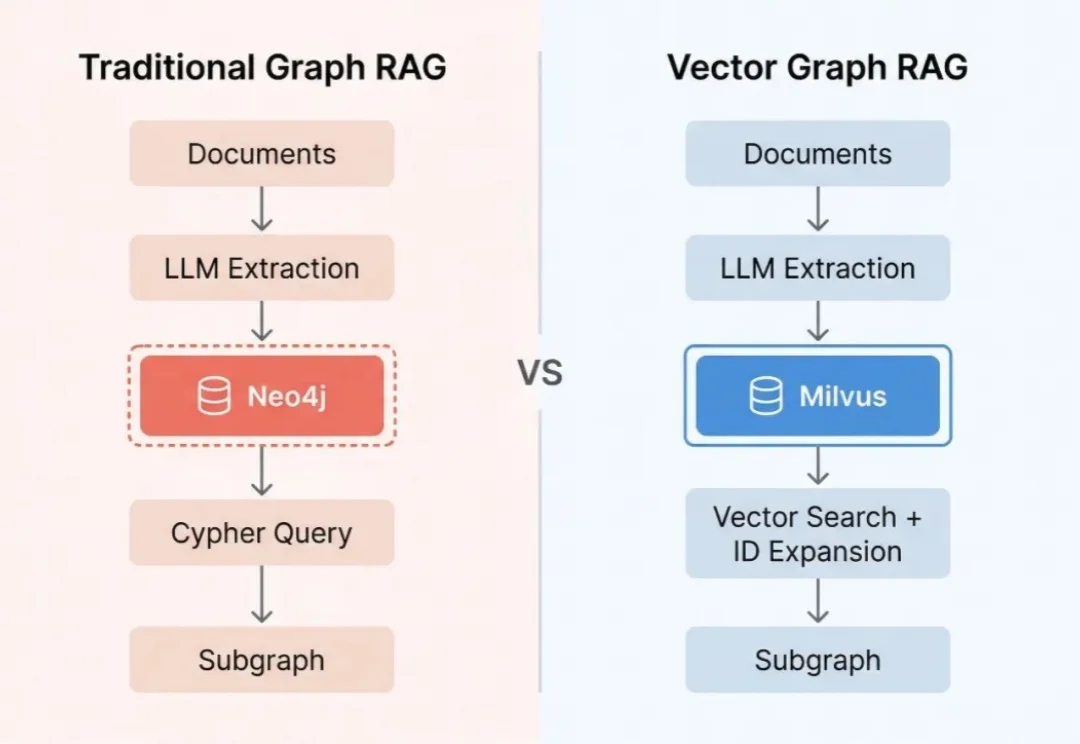
前段时间,我们做了一个开源项目 Vector Graph RAG,尝试只用 Milvus 向量数据库实现知识图谱的多跳检索,省去额外部署图数据库的麻烦。
Hermes也要做Personal Agent。
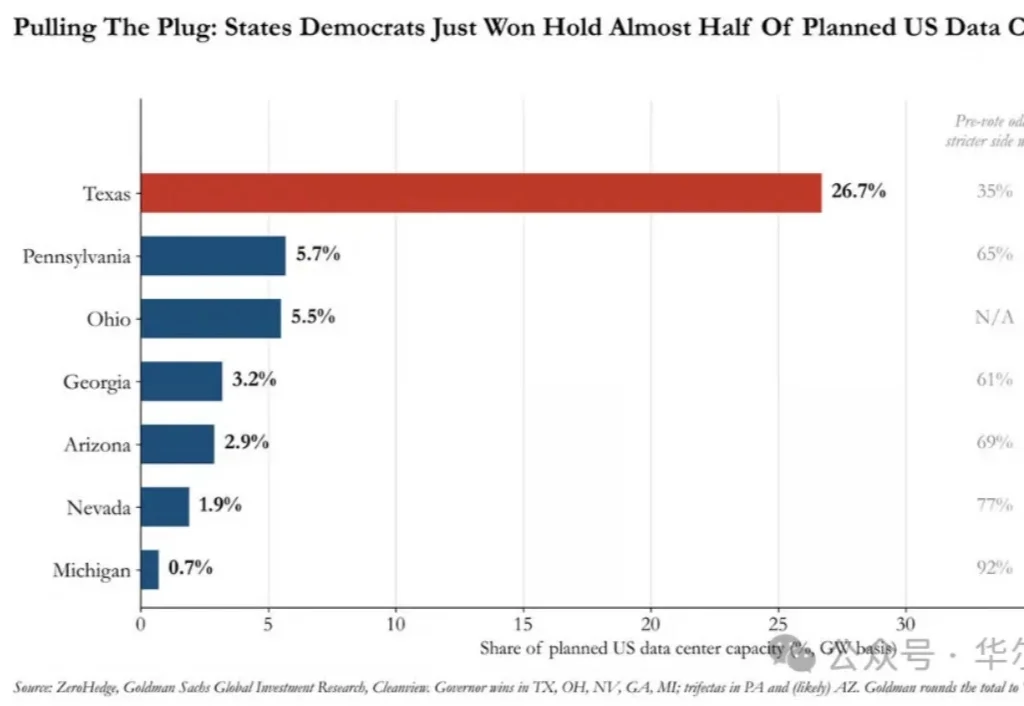
得克萨斯州变天,美国AI建设的最大单一州刚刚拉下了“闸刀”。
国庆前「elsewhere」发了一篇关于数据的文章。文中着重写的那几家明星数商只是掐尖的公司,但更庞大的是这个行业的水下。过去一段时间,我了解到的数据行业的辐射面之广、行业现状之惊诧,还是超过了我的预期。
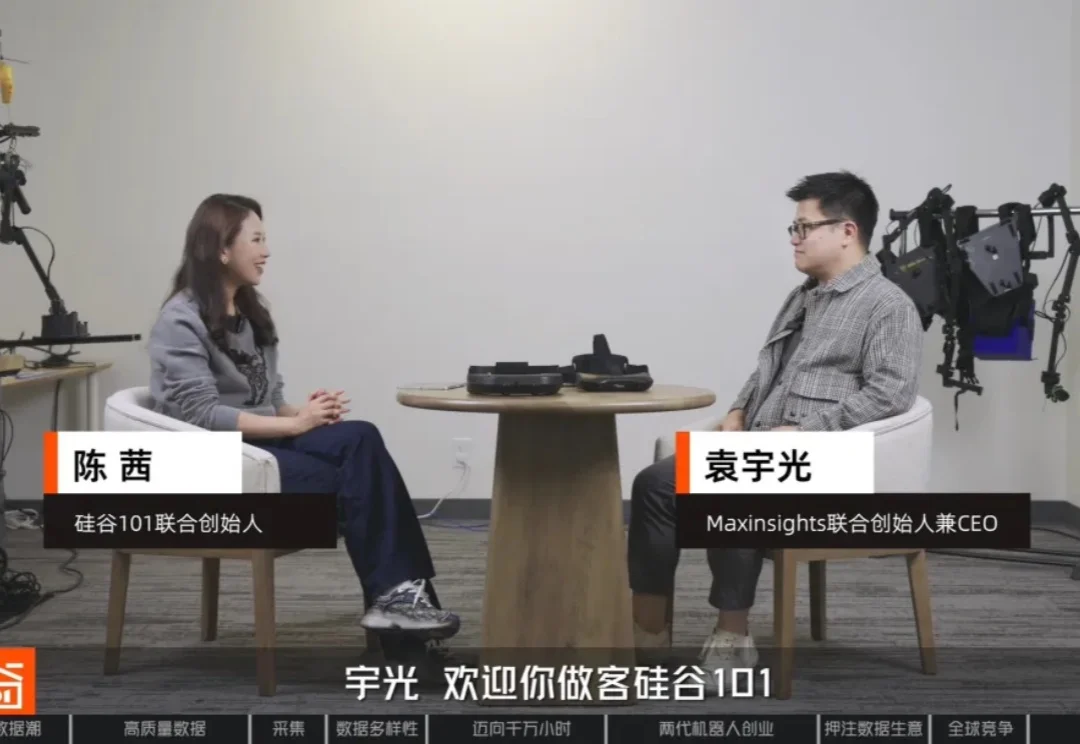
过去两年,在采访机器人公司时,我们听到最多的一句话就是:太缺数据了。
日常生活里人类的直觉判断,放到机器人身上,往往会变成棘手难题。
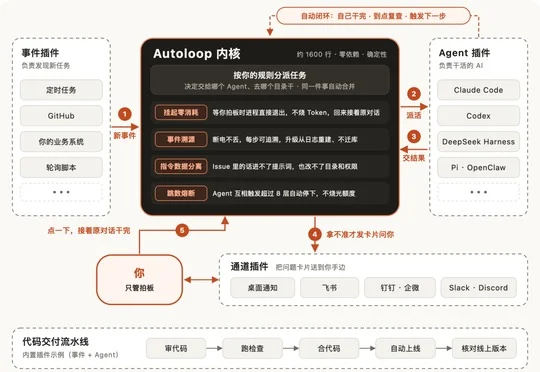
卡兹克开源其打磨一年的Agent自动化系统Agent-Autoloop,重写为约1600行代码的轻量内核,采用万物皆插件架构,事件、Agent、通知通道与CI交付均插件化,并内置挂起零消耗、事件溯源、指令数据分离、跳数熔断等机制,当前版本为1.0.0。