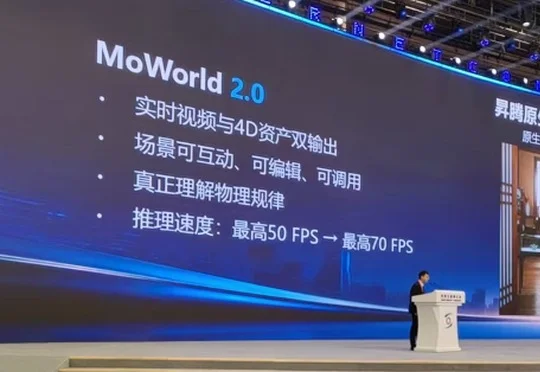
浙大00后博士生再交卷!把十几种物理要素装进一个世界模型|华为昇腾原生
浙大00后博士生再交卷!把十几种物理要素装进一个世界模型|华为昇腾原生魔芯科技在世界互联网大会发布通用4D世界模型MoWorld 2.0,将十余种物理要素纳入统一建模,并通过华为昇腾NPU协同优化将实时视频推理速度提升至70 FPS。
来自主题: AI资讯
8020 点击 2026-11-07 14:48

 搜索
魔芯科技在世界互联网大会发布通用4D世界模型MoWorld 2.0,将十余种物理要素纳入统一建模,并通过华为昇腾NPU协同优化将实时视频推理速度提升至70 FPS。
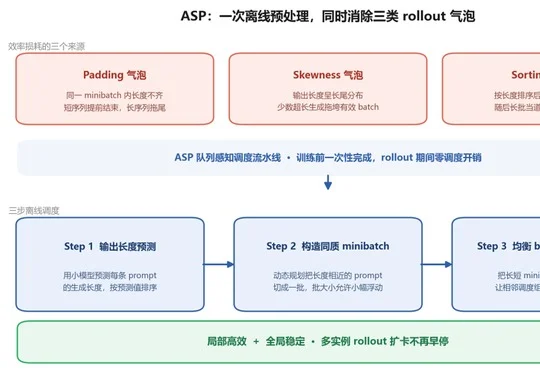
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
Hy4也正为递归自我改进(RSI)做准备。
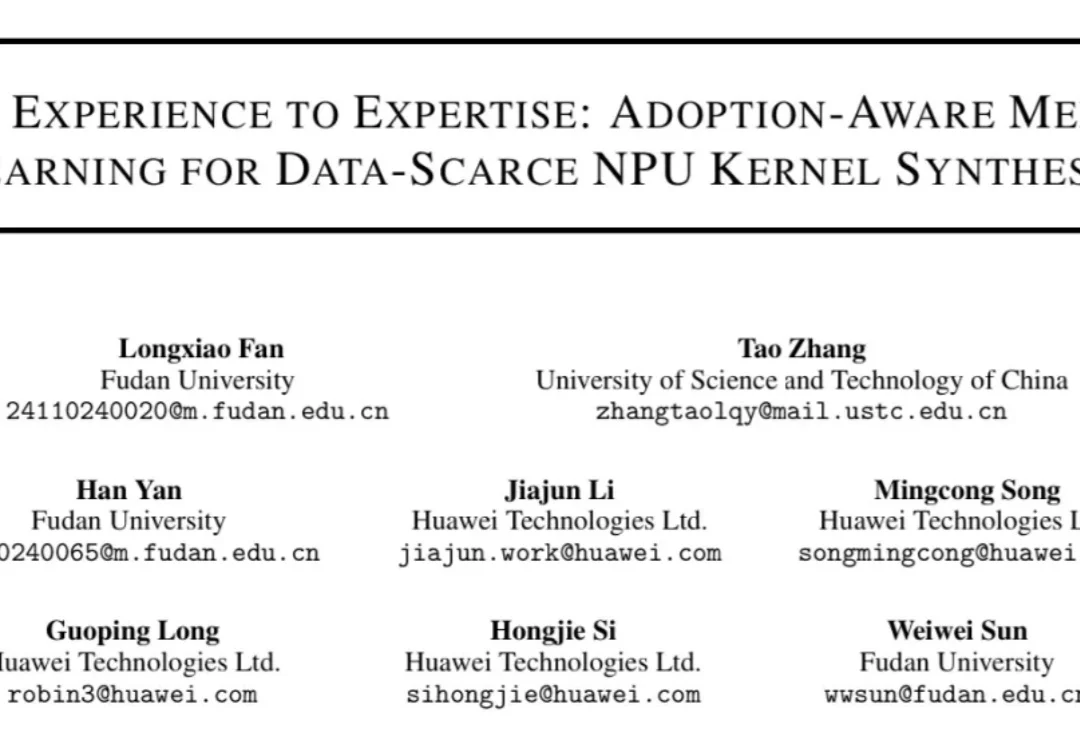
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
上海交大00后团队创办的芯生代完成数千万元种子轮融资,计划让Agent为不同模型、芯片和场景生成可自我迭代的定制推理引擎,其EvoKernel框架已将昇腾算子生成正确率从4%提升至83%。
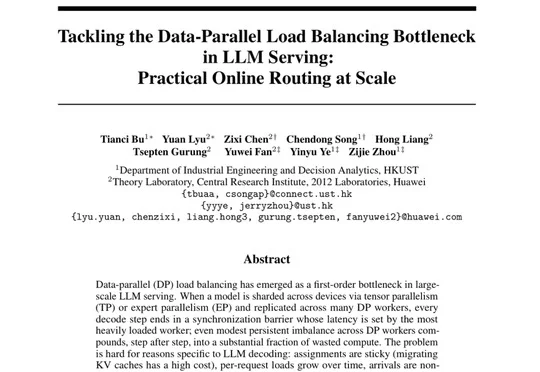
香港科技大学周子杰团队与华为 2012 实验室理论部提出 BalanceRoute,通过建模与短期负载预测减少 MoE 模型解码的跨组同步等待,其已部署于 MathBot-Pie,并在 96 张昇腾 910C NPU 实验中使解码吞吐提升约 15%。
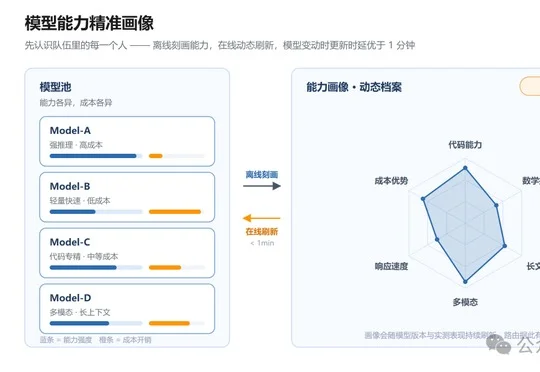
不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。不是所有任务都需要最强的模型。让每一次请求选对模型,让每一次反馈都成为下一次更优、更省的选择。
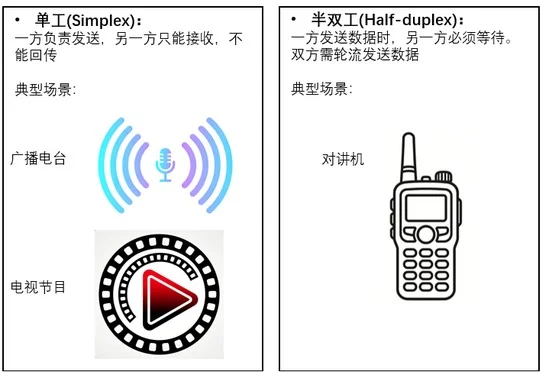
openJiuwen WorkSwarm首发全双工多模态能力,实现用户在前台像聊天一样随时与Agent交互、插话和追问,复杂任务则交给后台Core Agent独立执行,且原生亲和昇腾算力,支持基于华为云ModelArts与vLLM-Omni框架在昇腾NPU上部署。
DeepSeek开源面向华为昇腾算力平台的基础设施组件,涵盖TileLang编译工具及DeepGEMM、DeepEP、TileKernels、FlashMLA、DeepSelect等计算与通信库,华为亦在CANN社区开源双方围绕昇腾950及超节点的联合创新实践。
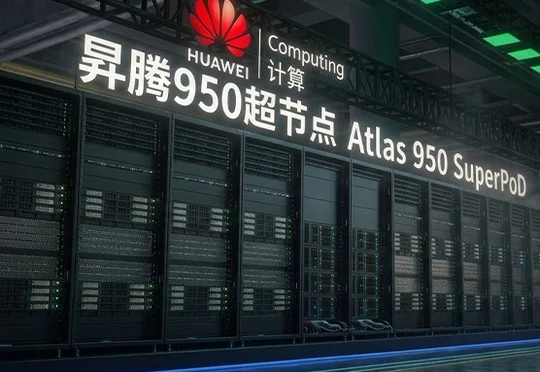
华为昇腾950超节点在华为全联接大会2026正式上市,作为业界最大规模商用超节点,通过灵衢互联、统一内存编址等技术创新打破算力、存储、通信瓶颈,为十万亿级大模型训练与推理提供最优解。