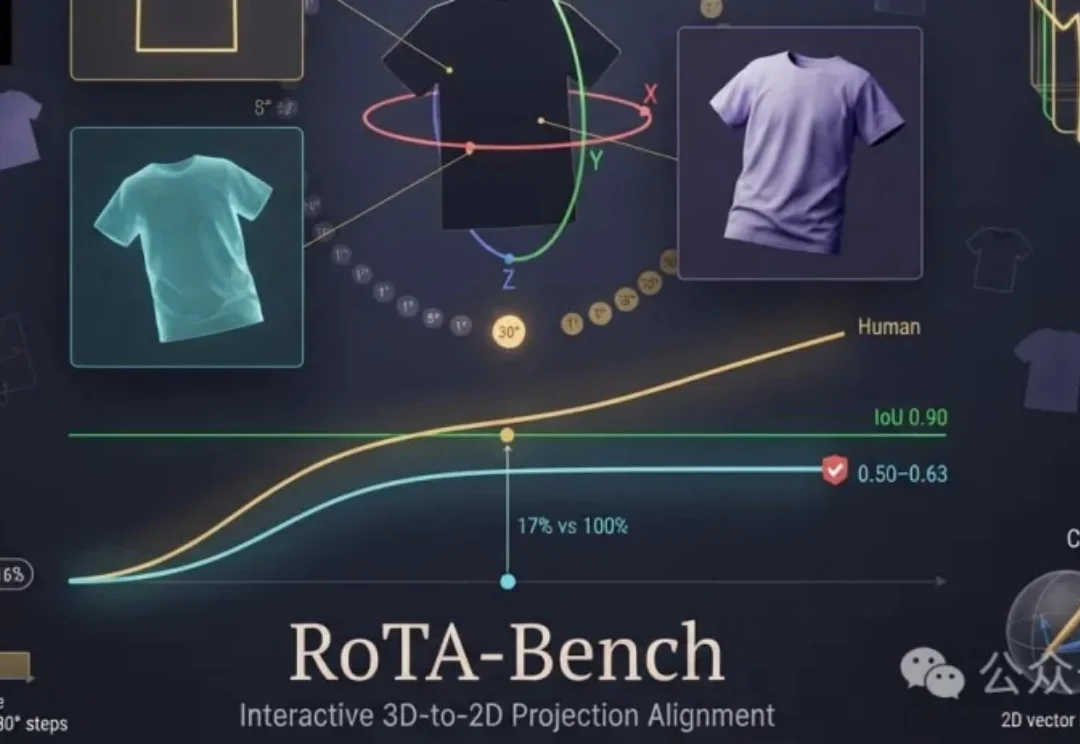
模型能感知调整3D物体位姿吗?首个交互式投影对齐空间推理基准
模型能感知调整3D物体位姿吗?首个交互式投影对齐空间推理基准认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
来自主题: AI技术研报
7659 点击 2026-11-05 17:01

 搜索
认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
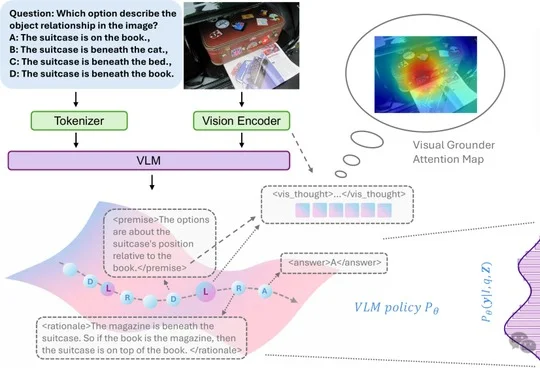
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
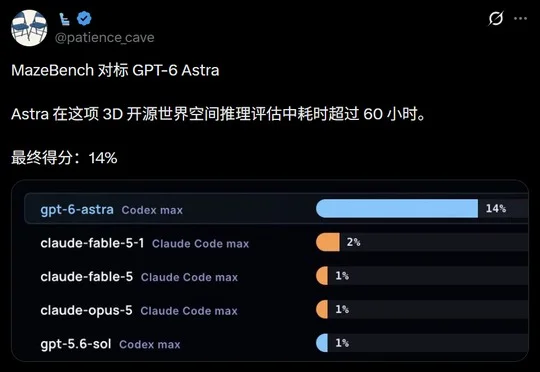
OpenAI的GPT-6 Astra登顶MazeBench等多项AI基准测试,以14%的成绩拿下3D空间推理第一,并在视频设计零件、3D分子交互模拟、频谱图识别声音等实际任务中展现出逼近AGI的全面能力,获得英伟达CEO黄仁勋认证为全球首个拿下AGI的团队。
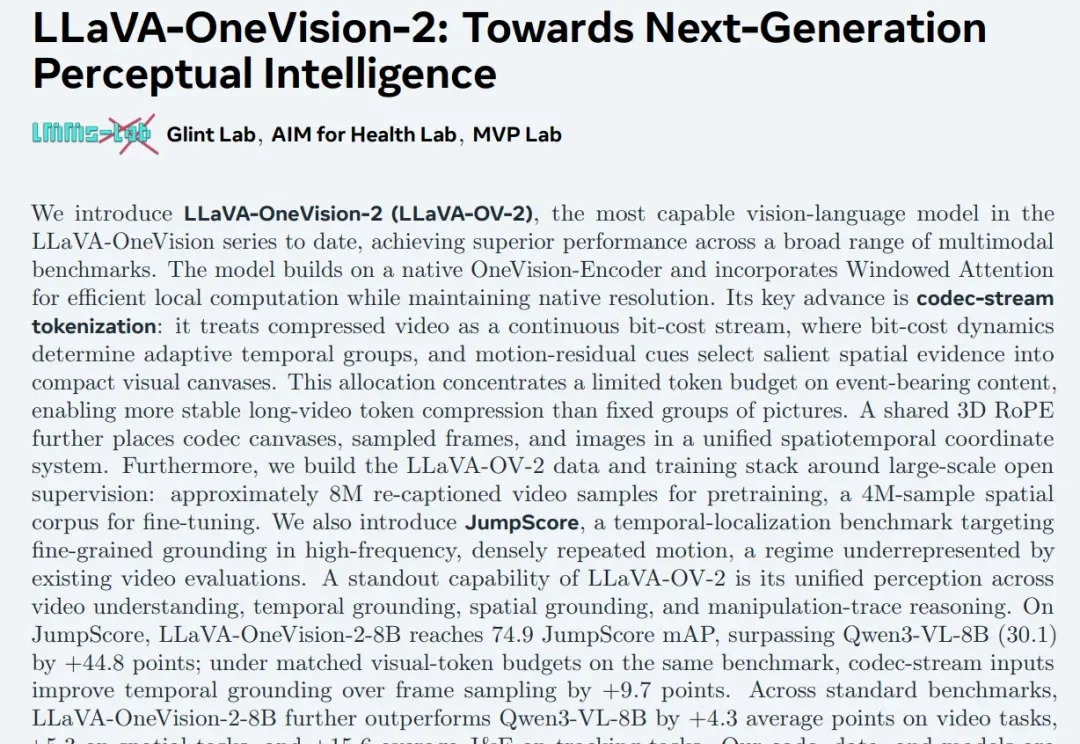
由格灵深瞳灵感实验室主导研发的 LLaVA-OneVision-2.0,是一款面向下一代感知智能的视觉语言大模型。团队充分利用视频 Codec 流和自研 OneVision-Encoder,实现跨帧、跨事件的增量观测和连续证据流建模。本文将详细介绍模型架构、训练方法与能力验证,展示该技术在视频理解、空间推理和目标追踪等任务中的应用潜力。
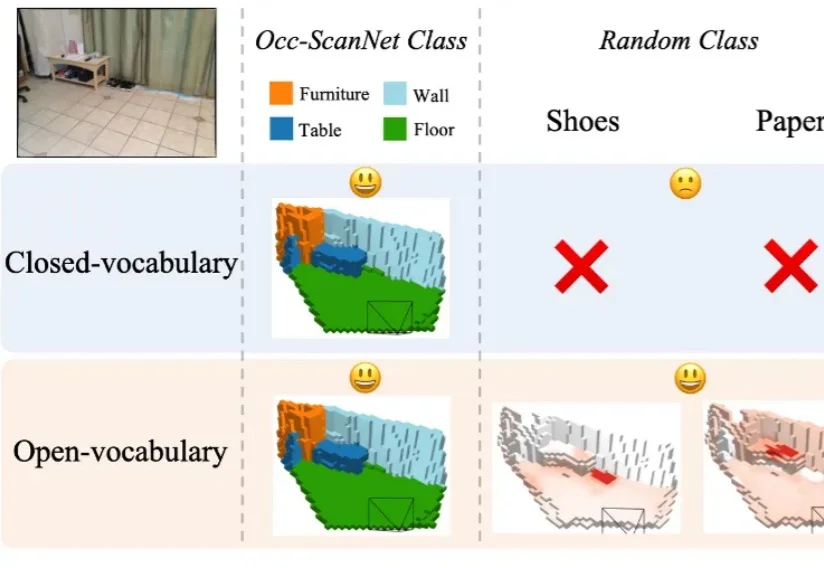
在具身智能研究中,如何让智能体精准理解周围环境的精细几何结构与开放语义信息,始终是具身感知的核心难题。近年来,语义占据预测(Semantic Occupancy Prediction) 将稠密几何与语义信息统一到三维体素网格中,用于构建 3D 语义占据地图,为机器人的空间推理、导航与交互操作提供了场景表达基础。
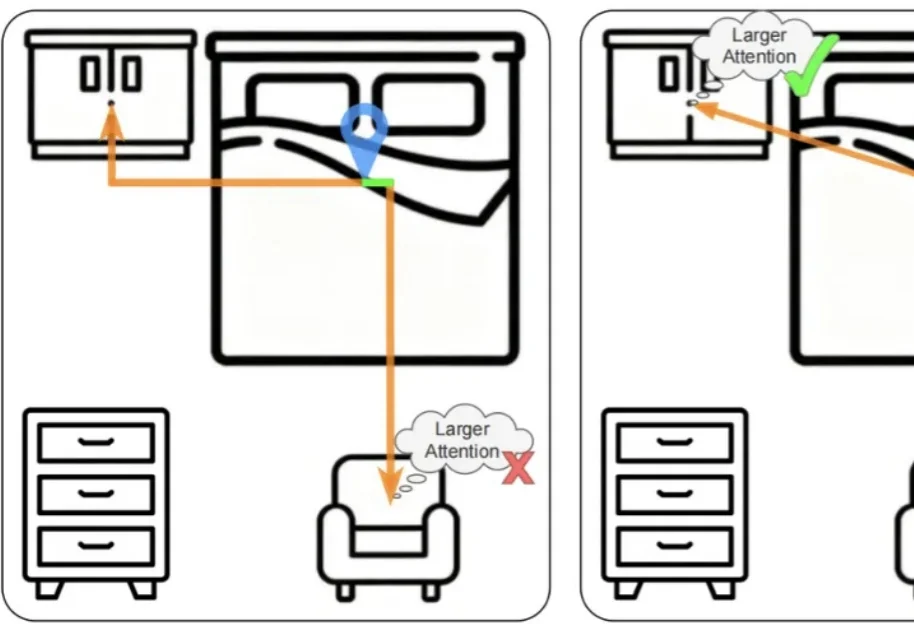
本文主要介绍来自该团队的最新论文:Scalable Object Relation Encoding for Better 3D Spatial Reasoning in Large Language Models。
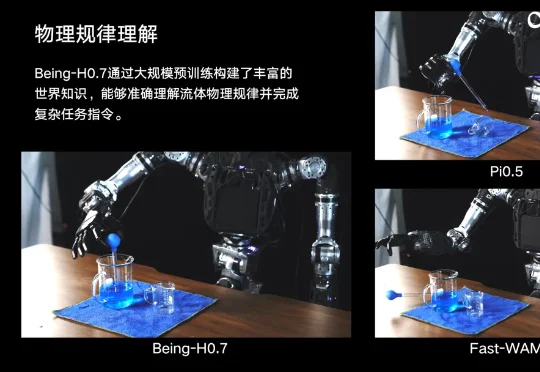
4 月 14 日,智在无界发布第三代旗舰模型 Being-H0.7,该模型将数据规模扩展至 20 万小时人类视频,并提出一种全新的范式 —— 基于潜空间推理的世界模型。在 6 项国际性权威评测中,H0.7 综合排名全球第一(其中 4 项登顶),同时也是首个覆盖跨本体、跨场景、连续动态、流体、柔性物体、物理规律与上下文推理等七大关键维度的通用世界模型。
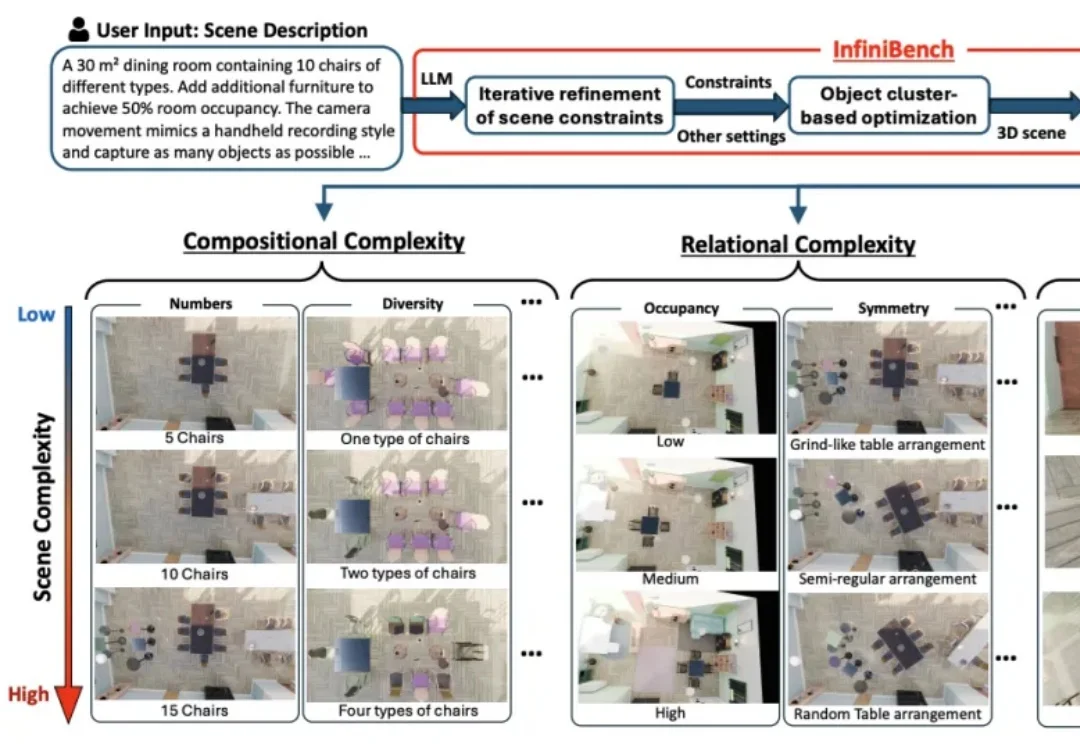
VLM看图像描述头头是道,一遇到3D空间推理就“晕菜”。
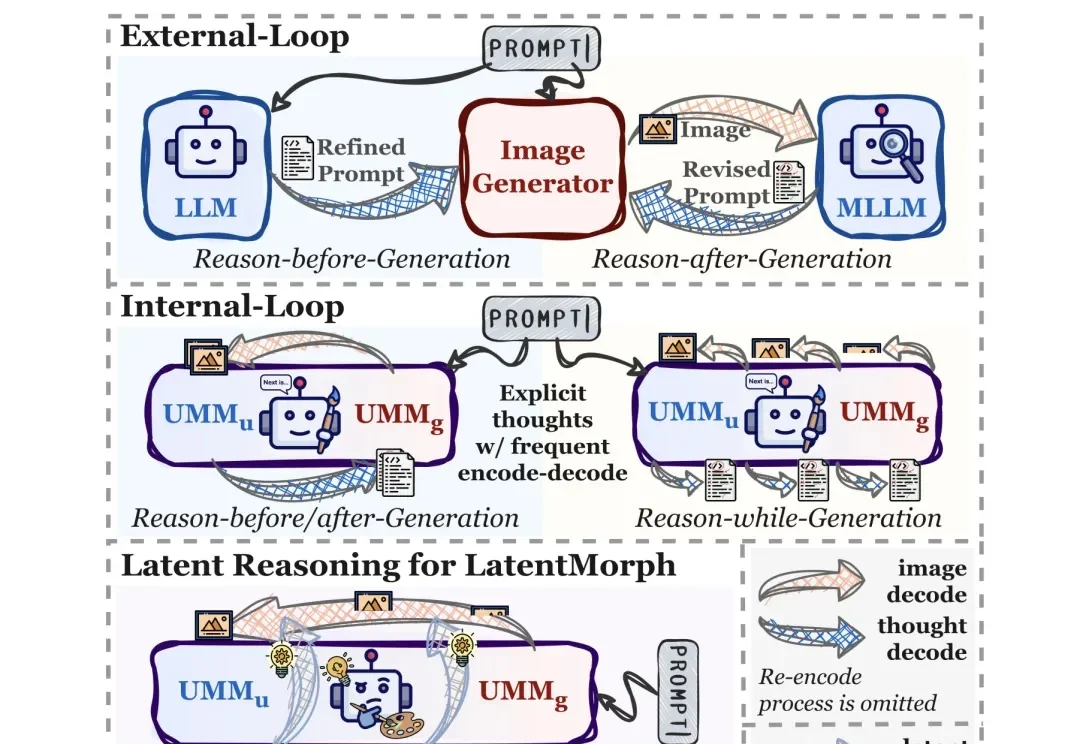
人类在创作艺术时,大脑并非一味地输出,而是在每一笔落下时都在进行着复杂的、难以言表的 “视觉优化”。