AI资讯新闻榜单内容搜索-语言模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 语言模型
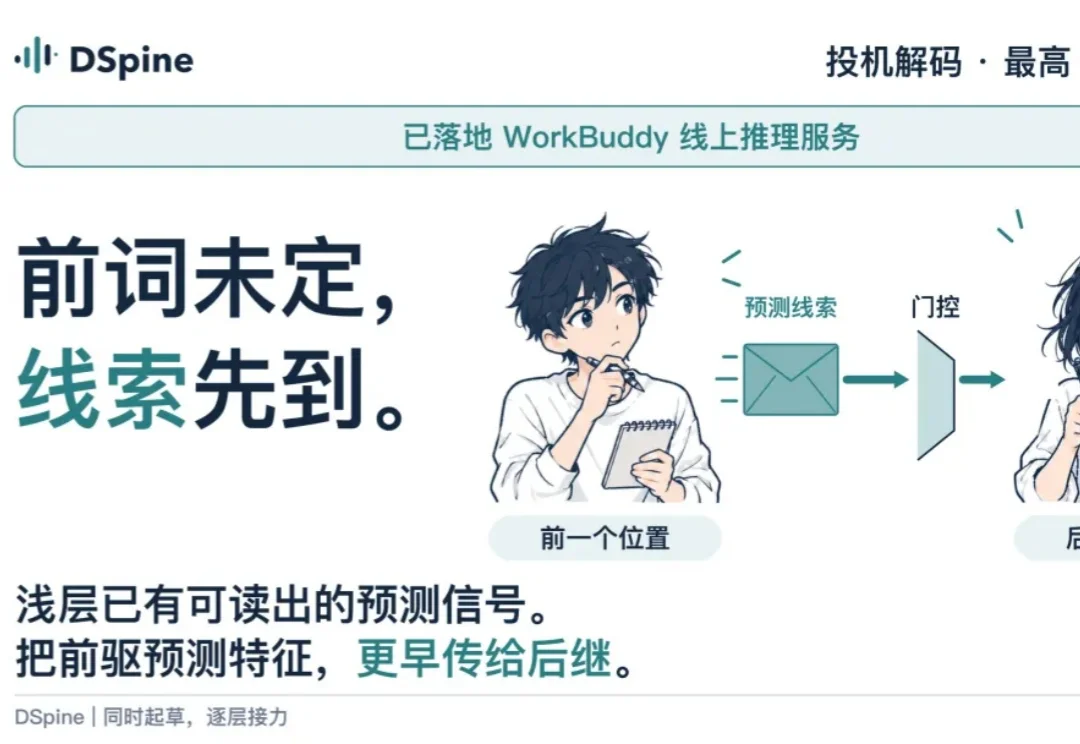
并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源

在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。

来自主题: AI技术研报
6173 点击    2026-11-10 09:23
决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

决策模型何时需要思考?StartLux-Decision的按需推理与概率校准

经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。

来自主题: AI技术研报
6177 点击    2026-11-05 10:19
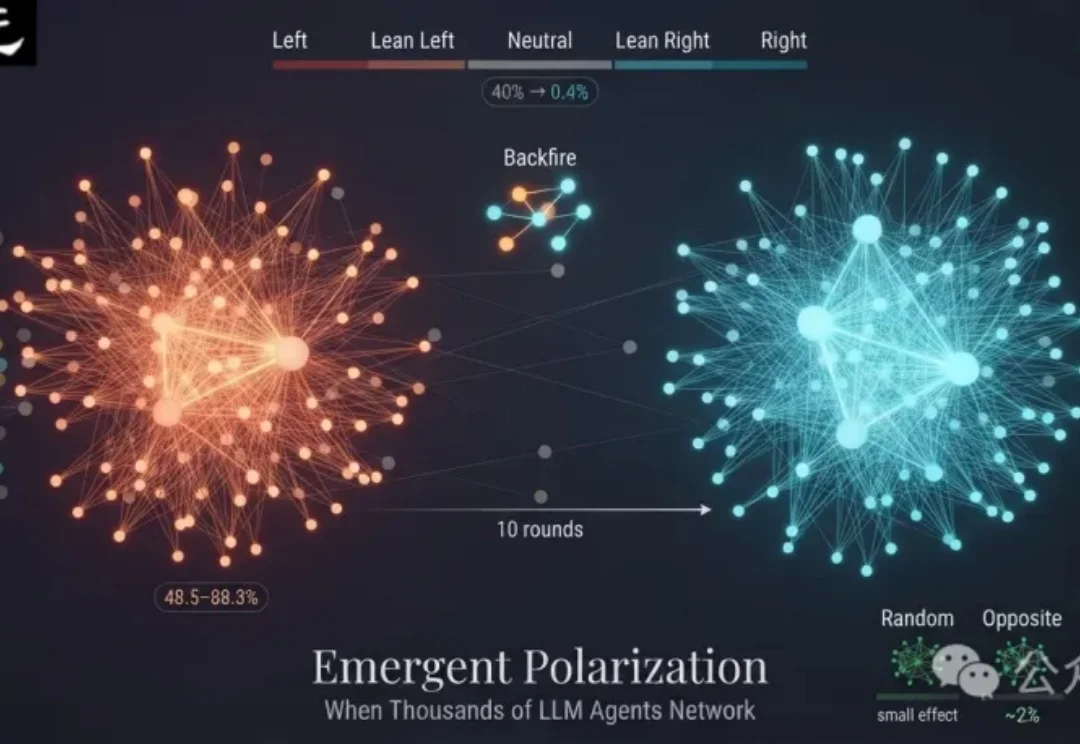
清华Nature子刊:上千智能体组网后自发站队,观点极化涌现

清华Nature子刊:上千智能体组网后自发站队,观点极化涌现

清华Nature子刊:上千智能体组网后自发站队,观点极化涌现

当数千个大语言模型智能体被连入同一个网络、彼此可以自由交流并不断更新观点时,会发生什么?

来自主题: AI技术研报
8190 点击    2026-11-04 09:51
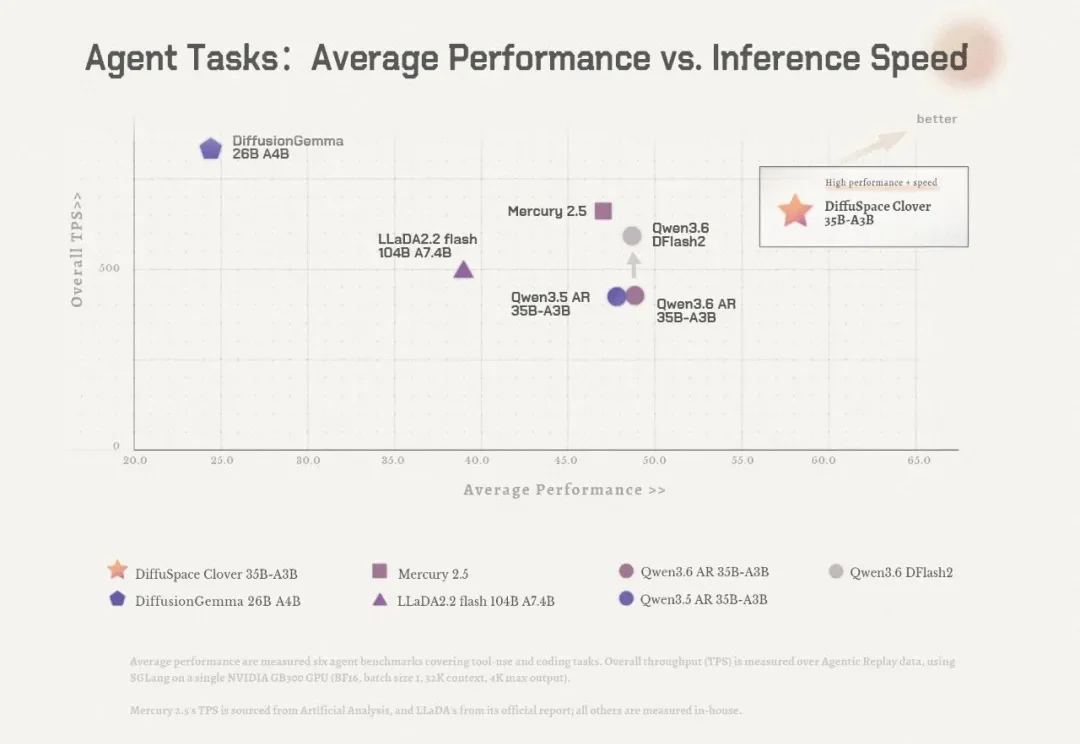
今天,扩散智能(DiffuSpace)发布源扩散语言模型 Clover-35B-A3B-Preview

今天,扩散智能(DiffuSpace)发布源扩散语言模型 Clover-35B-A3B-Preview

今天,扩散智能(DiffuSpace)发布源扩散语言模型 Clover-35B-A3B-Preview

编辑|张倩 2008 年,英伟达曾用一场颇为疯狂的实验,向人们展示并行计算的威力。 在现场,一台绘画机器人按部就班、一个像素接一个像素地绘制出一幅「笑脸」简笔画。 但接下来,画风突变。工作人员启动了一

来自主题: AI技术研报
6599 点击    2026-11-03 11:56
Tripo最会打小人

Tripo最会打小人

Tripo最会打小人

国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。

来自主题: AI资讯
5723 点击    2026-11-03 10:39
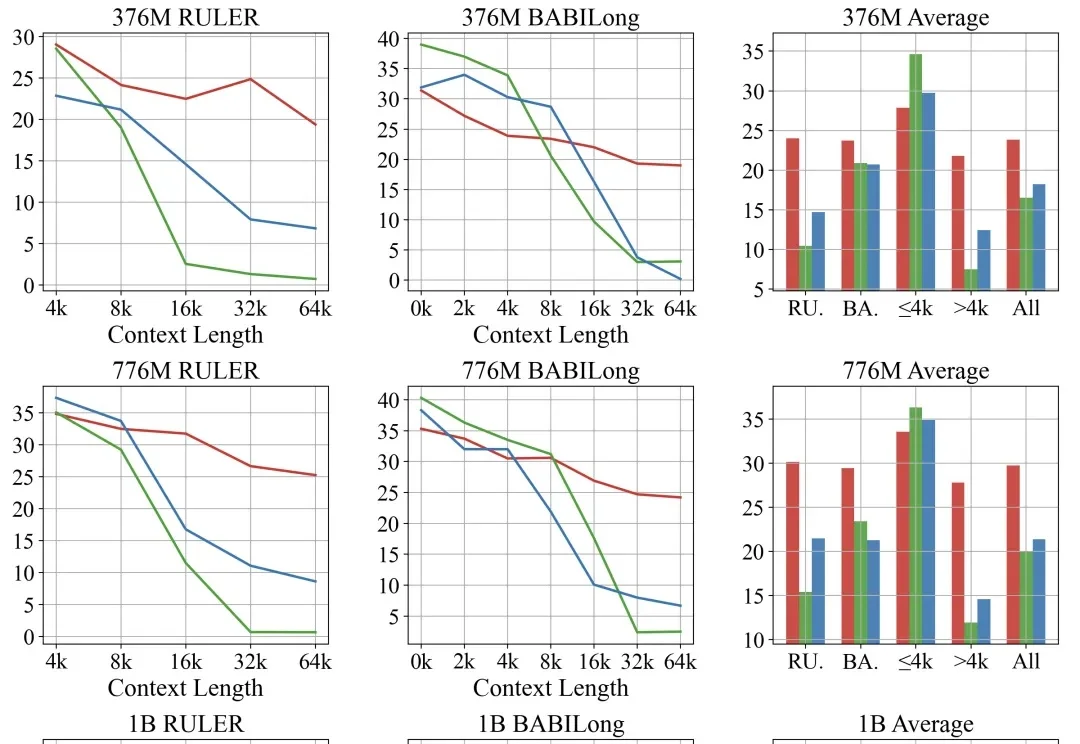
混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

混合架构用线性注意力还是滑窗注意力?复旦创智OpenMOSS团队:我全都要

长上下文已经成为大语言模型重要的基础能力,但长上下文也给模型架构带来了一个现实问题:全注意力能够直接建模任意位置之间的关系,却带来随序列长度显著增长的计算和显存开销;滑窗注意力和线性注意力更加高效,但效果上都存在明显的不足。因此混合架构逐渐成为当前大语言模型设计的主流。

来自主题: AI技术研报
9522 点击    2026-11-02 10:59
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。

来自主题: AI技术研报
9247 点击    2026-11-02 10:33
大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

大模型开挂了!64量子比特,让11亿参数模型逆袭80亿

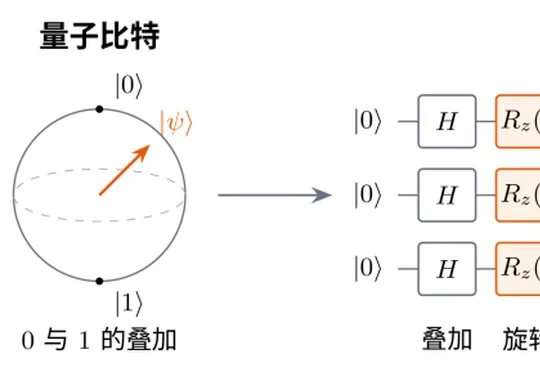
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。

来自主题: AI资讯
8203 点击    2026-10-24 13:40
NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

NeurIPS 2026 | 从Token到Span:重新思考大语言模型的不确定性估计

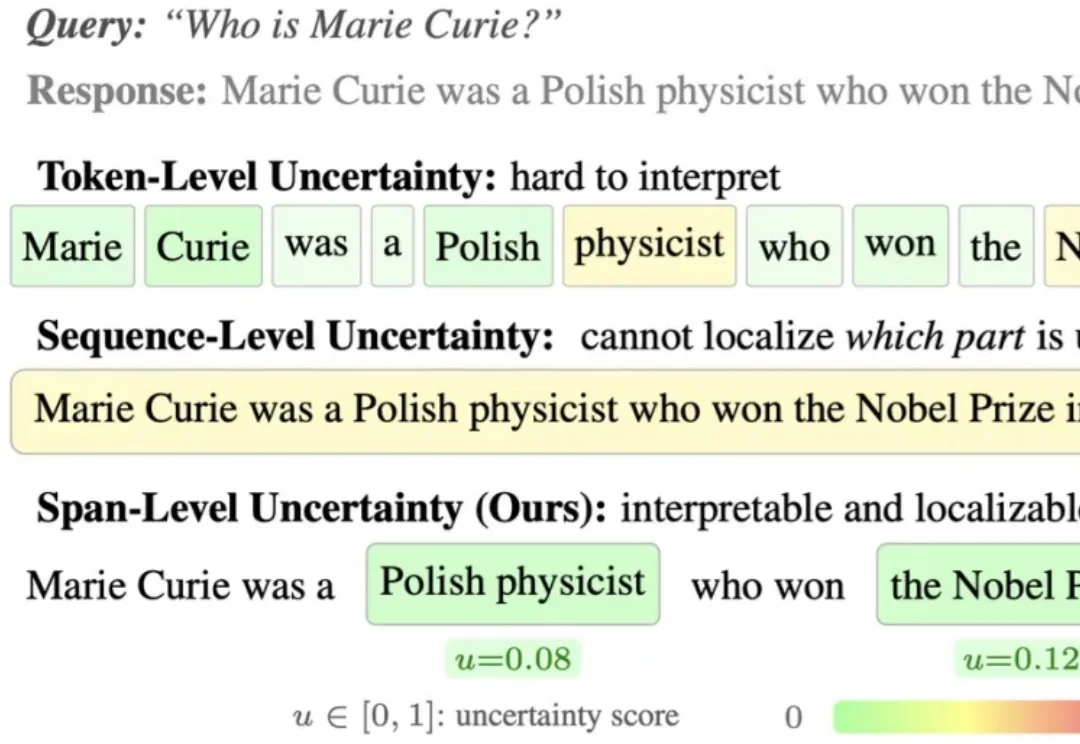
在将 LLM 真正应用到产品的过程中,我们经常会遇到一个看似简单、却非常关键的问题:模型生成的内容,究竟有多可信?

来自主题: AI技术研报
10673 点击    2026-10-23 09:58
VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

VLM脑中真有一张3D地图?匹兹堡大学挖出了新证据

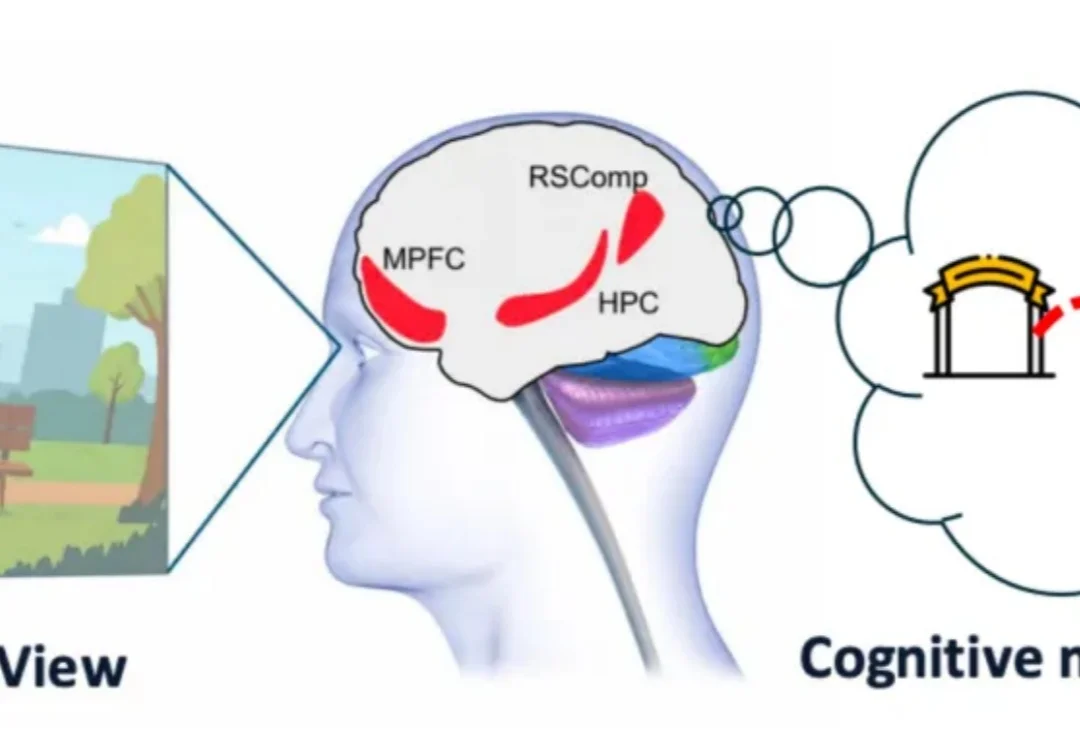
看一段房间视频,视觉语言模型(VLM)能够认出桌子、椅子和柜子。但在它的内部,这些物体是按颜色、形状组织在一起,还是形成了一张包含邻接关系的空间地图?

来自主题: AI技术研报
9053 点击    2026-10-20 16:22